휴대용 이식의 기본 이야기가 「해상도를 내리고, 효과를 끄고, 핸드헬드용으로 최적화했다고 적는다」에서 멈추기 쉽다면, 2026년 10월 14일 밤 Anbernic RG DS Plus에서 일어난 일은 같은 문장을 다른 문법으로 다시 쓴다. 브라우저 스노보드 게임 Falllinie의 네이티브 C++/OpenGL ES 이식은 듀얼 1024×768 패널, ROCKNIX와 Sway 위에서 돈다. 실기 플레이에서는 대략 열세 번 리프레시마다 한 번 빠졌다. 그날 밤이 끝날 무렵, 출시 빌드는 모든 리프레시를 지키고 내부 해상도를 더 선명한 512×384로 올린 채 Ports 메뉴에 올랐다.
이 글을 관통하는 이미지는 먼 사면에서 어떤 샘플 점도도 덮지 못하는 삼각형이다. 농담처럼 들리지만, 이 단일 코어 Mali-G52가 실제로 치르던 비용이다. 제출된 삼각형의 약 59%는 픽셀 샘플을 하나도 덮지 않는다. 0.8 m마다 늘어선 지형 행은 스치는 각도에서 서브픽셀 파편으로 줄어들면서도 기하 단계를 채운다. 아래의 숫자, 합격 규칙, 거부된 지름길은 모두 그 사실 주위를 돈다.
공개된 공학 노트 두 편을 대조했다. 그날 밤의 심층 보고와 전날의 성능 리뷰다. 카운터, 리플레이 서명, 합격표는 충분히 단단하다. 아래는 검증 가능한 사실만 쓰고, 기기 로그에 없는 장면은 보태지 않는다.
一. 16.667 ms, 누락 리프레시가 통째로 빈칸이 되는 방식
예산은 하드웨어에 적혀 있다. RK3568은 Cortex-A55 네 개, GPU는 Mali-G52의 **하나의** 셰이더 코어, 800 MHz, 약 975 MiB RAM, 스왑 없음. 양쪽 1024×768 패널은 각 60 Hz로 리프레시하므로 매 프레임 위아래 화면에 새 그림을 넘겨야 한다. 프레임 주기는 약 16.667 ms. 그 창 안에서 GPU가 움직일 수 있는 상한은
800 × 10^6 cycles/s × 16.667 ms = 13.33 × 10^6 cycles.
각 뷰는 GPU 패스 셋을 세 번 돌린다. 씬 패스가 지형·오브젝트·라이더·파티클을 작은 오프스크린에 그리고, 프린트 패스가 인코딩 이미지를 망점·잉크 윤곽·절차적 하늘로 바꾸며, 출력 패스가 결과를 1024×768 창에 복사하고 HUD를 올린다. 단일 메인 스레드가 모두 발행한 뒤 두 창을 Sway에 넘긴다. 위 화면은 삼인칭, 아래는 일인칭. 한 코어가 두 세트의 기하와 프래그먼트를 먹는다.
처음에는 「느리다」가 연속적인 프레임 하락으로 읽히기 쉽다. 측정은 다른 모양을 보였다. 실기 오토플레이에 오디오를 켠 평균 간격은 약 17.88 ms, ≥25 ms 프레임 7.6%, p95 약 27.8 ms. 리뷰가 여러 `frames.csv`를 쪼개 보면 평균 간격은 거의 정확히 16.667 ms에, 늦은 프레임마다 리프레시 한 구간을 더한 값이다. 이 기기에서 프레임 시간은 누락 리프레시 횟수에 가깝다. 한 번 초과하면 다음 박자를 통째로 잃는 경우가 많다. 박자는 디스플레이 리프레시와 창 버퍼 획득에 묶이고, swap 자체는 약 0.3 ms다.
이후 명시적 클리어로 대기를 못 박았다. 어떤 창의 첫 프레임버퍼 연산에서 벽시계는 약 9.5 ms, 메인 스레드 CPU는 0.5 ms 미만. 어느 창이 더 오래 기다리는지는 세션 위상에 따라 바뀐다. 최적화 표적도 바뀌어야 한다. 평균이 예뻐도 부족하다. 플레이어가 보는 것은 누락 리프레시 비율이다. 남은 여유보다 작은 절약은 포화 중에는 거의 보이지 않고, 프레임 전체가 리프레시 창에 들어가는 순간 같은 절약이 긴 프레임을 한꺼번에 지운다.
나무·레일·파티클·관절 라이더·잔향 오디오를 더한 통합판은 대략 50 FPS, 중앙 루프 간격 약 19.8 ms였다. 이전 플레이 가능 포트는 기능을 줄인 384×288에서 60을 지켰다. 목표는 단호하다. 60을 되찾고, 시각·오디오 충실도는 내놓지 않는다. 저장소 규칙은 원본 셰이더 본문을 경성 제약으로 두고, 모든 적응을 명시 등록한다.
二. 기하의 운명, 오만 구천 개 삼각형이 영 픽셀이 되는 이유
초기 조사는 이미 세 가지 사실을 갖고 있었지만 오래도록 한 문장 진단으로 용접되지 않았다. GPU-active는 거의 클록과 같고, 프래그먼트 활성은 그 시간의 약 99%에 존재하며, 메인 스레드 CPU는 프레임 예산보다 훨씬 낮다. 합치면 GPU 포화다. 그다음 모든 길을 가른 질문은, 포화가 무엇을 먹고 있느냐였다.
출하 크기 리플레이에서 기하 카운터는 단단한 표를 냈다. 루프 프레임당 양 뷰 합산으로 제출 프리미티브 약 424,955, 샘플 미커버 약 251,571, 근원 밖 약 84,813, 후면·측면 밖 약 22,243, 가시 약 66,328. 위치 셰이더 스레드 약 447,477, 완전 varying 약 76,585. 비프래그먼트 활성 약 7.21 M, GPU-active 약 13.95 M. 대략 열 중 여섯 삼각형은 픽셀을 만들지 않고, 기하는 활성 시간의 약 절반을 차지한다.
원천은 지형 메시다. 사면 방향으로 0.8 m마다 한 행, 각 행 107열. 약 110 m 셀은 약 29,256 삼각형. 상주 일곱 셀, 라이더 뒤 하나·앞 다섯. 지형만으로 뷰당 약 20만 5천 삼각형, 384×288 내부 화소 110,592 대비 약 1.85 삼각형/픽셀. 안개는 400 m에서 가득한데 그리기는 앞쪽 약 660 m까지 뻗는다. 먼 행은 스치는 각에서 화소 파편으로 줄고, 타일 기반 GPU는 여전히 위치 셰이딩·조립·폐기를 치른다. 단일 코어에서는 기하와 프래그먼트가 같은 실행 유닛을 다툰다. 서브픽셀 삼각형은 쿼드 과셰이딩도 끌어온다. 먼 사면에서 샘플을 덮지 못하는 59%의 삼각형이 단일 코어 청구서에서 가장 비싼 침묵이다.
리뷰는 직설적이다. 측정 규율은 우수하고 우선순위는 약하다. 기하 밀도와 「안개는 가득한데 아직 그린다」는 늦게야 이름이 불렸다. 인디 휴대 이식에게 그 문장은 꾸지람보다 업계 좌표에 가깝다. 질문을 틀린 정밀 기기는 달력만 채운다. 결정적 데이터는 종종 값싼 실험과 올바른 질문을 향한 카운터 한 세트에서 온다. 더 예쁜 프로브를 고르기 전에 제약 자원을 이름 붙여라.
三. 이미지를 바꾸지 않는 네 칼, 그리고 거부된 지름길
이미지 불변 최적화에는 문서화된 승격 규칙이 있었다. 플래그로 시작, 리플레이 서명 불변, 다섯 체크포인트 여덟 장 바이트 일치, ABBA에서 더 느리지 않음, GL 오류 없음과 측정 완전. 이 보고의 모든 리플레이 서명은 `6081555844518115723`. 픽셀을 하나라도 바꾸면 기기 나란히 캡처를 프로젝트 주인에게 넘기고, 기본값에 몰래 섞지 않는다.
첫 칼은 섀도 바운드. 씬 셰이더는 모든 지형 프래그먼트에 라이더 몸·보드의 세 구간 ray-to-segment 그림자를 평가한다. 보수적 테스트는 빛 방향으로 2D 좌표에 투영해 라이더 구간을 가두고, 가둔 안에서만 원본 루프를 돌린다. 출하 384×288 리플레이에서 원본 그림자 평균 17.273 ms, p95 20.399, ≥25 ms 3.9%; 바운드 후 16.620 / 17.611 / 0.0%. 오디오 켜면 ≥25 ms가 6.5%에서 0.5%로. 바운드만으로 출하 구성이 60 Hz에 들어갔다. GPU는 거의 만석, 여유는 거의 영. 포화일 때 프레임당 활성 사이클은 클록÷프레임레이트일 뿐이라, 절약은 다른 곳에서 잰다.
둘째 칼은 행 블록 컬링. 지형 인덱스는 행 단위로 쓰이므로 연속 16행(약 12.8 m)은 연속 인덱스 구간이다. 각 블록은 참조 정점의 AABB를 저장한다. 그리기 전 여덟 모서리를 클립 공간으로 옮긴다. 여덟 점이 같은 반공간 밖에 모이면 블록을 건너뛴다. 클립 좌표는 위치에 선형이고, 상자 안 점은 모서리의 볼록 결합이다. 모서리가 모두 한 반공간 밖이면 상자 안도 밖이다. 블록 안 삼각형은 프래그먼트를 만들 수 없으니 드로우를 건너뛰어도 이미지는 안 바뀐다. 남은 블록은 원래 순서로 가능한 한 적은 드로우로 합친다. CPU 테스트는 같은 부동식을 약 778만 점, 거부된 상자 19,460개로 검증했다. 110 m 셀 통째 컬링은 거의 안 먹힌다. 셀이 너무 넓어 양쪽 뷰와 거의 항상 겹치기 때문이다.
셋째 칼은 16비트 인덱스. 한 셀 14,873 정점이라 인덱스는 16비트에 들어간다. 업로드 때 좁혀 값·순서는 그대로 두고 인덱스 트래픽을 절반으로 줄인다. 동적 메시·라이더·다중 셀 정적 픽스처는 32비트를 유지한다.
넷째는 측정이다. 출력 패스 맨 앞 클리어를 독립 타이밍에 넣으면 약 9.5 ms 벽시계 대기는 버퍼 획득으로 고정되고, 「렌더가 느리다」는 모호함에 섞이지 않는다. swap은 약 0.3 ms. 스왑 간격이 0이어도 루프는 창에 대한 첫 드로우의 버퍼 획득에 박자를 맞춘다.
논증도 성립하고 이미지도 바이트 일치인데 거부된 칼이 하나 있다. 안개는 400 m에서 상수 출력을 쓴다. 완전 안개 블록은 단락 셰이더로 그릴 수 있어야 했다. 오프라인 컴파일러는 추가 분기가 최장 산술 경로를 11.03에서 11.20으로 늘려 모든 프래그먼트가 함께 느려지고, 이득은 얇은 원거리 띠뿐이라고 보여 주었다. 512×384에서 평균은 약 20.571에서 더 나쁜 20.712로. 지름길은 opt-in으로 남고 거부로 기록됐다. 예쁜 증명은 길어진 공통 경로를 이기지 못한다.
세 칼이 기본값이 된 뒤 실기 오토플레이+오디오에서 ≥25 ms는 7.6%에서 0.1%, p95는 27.8에서 17.2 ms로. GPU는 여전히 약 98% 바쁘다. 이미지 불변의 칼은 출하 크기를 예산 가장자리까지 밀어 올렸고, 더 선명한 내부 해상도를 살 여유는 거의 남기지 않았다.
四. 이미지를 바꾸는 한 칼, 여유를 정확한 두 배에 쓰기
컬링은 가장 큰 비용에 닿지 못한다. 화면 위에 있지만 샘플보다 작은 삼각형은 먼 디테일을 줄여야 사라진다. 설계는 변화를 최대한 작고 안전하게 잡는다.
각 16행 블록에서 거리로 LOD를 고른다. 레벨 L은 2^L행마다 한 행을 남기고 열은 107 전부. 쿼드는 원본 스트립과 같은 두 삼각형·와인딩. 블록 첫·끝 행은 항상 전체 열 해상도로 넣고, 이웃은 경계 정점을 공유해 레벨이 달라도 갈라짐이나 T접합이 없다. 근거리 N 안은 풀 디테일, 밖은 floor(log2(d/N))+1, 상한 4. 엘리먼트 버퍼는 원본 인덱스 뒤에 각 블록의 솎은 구간을 두고, 같은 레벨 인접을 한 드로우로 합친다. 행 블록 컬링과 16비트 인덱스는 계속 적용된다.
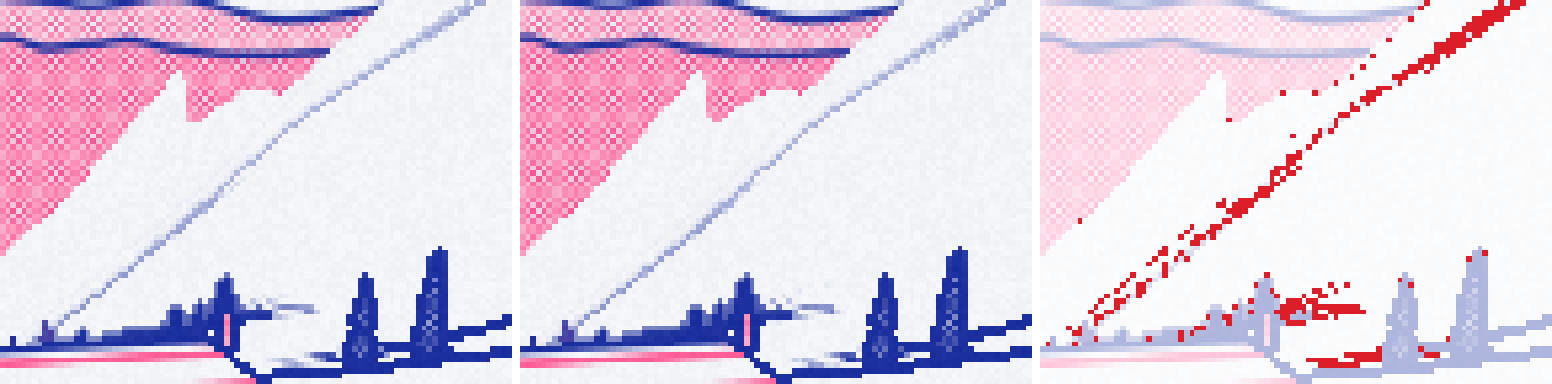
기기에서 풀 디테일 기본과 대조. 제출 삼각형 약 368,600→134,000(약 64% 감소), 샘플 미커버 약 252,000→54,500, 비프래그먼트 활성 약 5.26 M→2.80 M, 외부 읽기 약 21.2 MB→9.2 MB, 출하 크기 GPU 가동 약 99%→약 69%. 512×384 듀얼은 평균 약 20.12 ms·≥25 ms 21.0%에서 약 16.62 ms·0.0%로. 120 m 근거리는 픽셀 변경이 적고 GPU 약 77%, 절약도 적다. 주인은 나란히·스와이프·차분 페이지를 보고 60 m를 골랐다. 다섯 체크포인트에서 각 1024×768 창의 약 0.6%~1.4% 픽셀이 바뀌며, 먼 능선과 그 망점, 일부 등고선에 모인다.
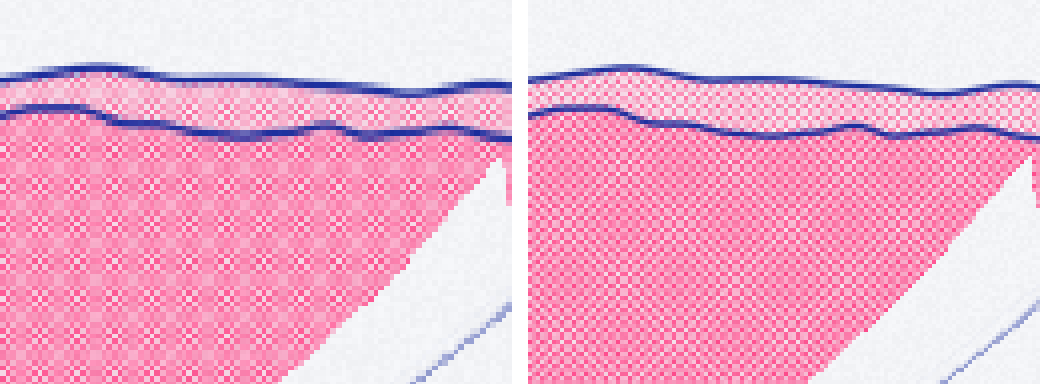
여유는 더 부하를 깎는 데 쓰이지 않았다. 주인은 512×384에 썼다. 1024×768 대비 정확한 2×다. 384×288의 최근접 확대는 2.667×라 텍셀이 3-3-2 폭 반복으로 떨어진다. 프린트 셰이더 망점 피치는 약 4.4 화면 픽셀. 불균일 격자와의 간섭으로 반조 영역에 격자무늬가 생기고, 2픽셀 열을 넘는 윤곽이 끈적해진다. 512×384에서는 각 텍셀이 2×2, 피치 2.2 텍셀로 패턴이 고르게 재현된다. 출력 복사는 픽셀당 약 1사이클이라 싸지만, 두 창 합쳐 약 157만 프래그먼트 스레드, 예산의 약 12%를 쓴다. 복사는 남기고 HUD 글자는 전체 창 해상도로 그린다.
60 m 지형과 오디오에서 두 내부 크기 모두 리플레이·실기 오토플레이로 60 Hz를 지키며 ≥25 ms 프레임은 없다. 512×384는 GPU의 약 93%, 384×288의 약 69%에 대비된다. 약 110초 실기 세션 세 번, 시드 42·7·1234, 합계 19,605프레임, **영** 누락 리프레시. 평균은 16.667 ms에 붙고, p95 약 16.73~16.75, 최장 약 19.75~21.74 ms, GPU 가동 약 89.5%~90.6%, 피크 메모리 99~102 MiB, GL 오류 없음, 오디오 언더런 없음.
출시 기본값은 섀도 바운드, 행 블록 컬링, 16비트 인덱스, `--terrain-lod 60`, 런처 `--render-size 512x384`. 배포 경로 `/storage/apps/falllinie-spike`, Ports 이름 Falllinie, 바이너리 sha256 `7f86667cc49c1aa15e725ee636f8db8f58445f1c79cf7fc6988c980f16363398`, 커밋 `0bf9969`. 이전 바이너리는 `falllinie-spike.previous`, `mv` 한 번으로 롤백한다.
맺음, 단일 코어 청구서에서 「최적화」를 다시 쓰기
Falllinie를 2026년 휴대·인디 이식 현장으로 되돌리면 다른 종류의 타성을 친다. 평균이 조금 나쁜 것을 품질 슬라이더 한 칸 내림으로 읽는 이도 있고, 포화된 GPU에서 CPU 제출을 줄이면 프레임을 살 수 있다고 믿는 이도 있다. 이미지를 지키는 지름길은 증명이 예뻐도 출하할 가치가 없을 수 있다.
이 길이 보여 주는 반례는 투박하고 단단하다. 제약 자원을 이름 붙인 뒤 계측기를 고른다. 포화일 때는 과부하 구성에서 절약을 잰다. 「제출/가시/이유별 컬링」을 가장 정보량 많은 표로 만든다. 이미지 동일성을 먼저 증명한 뒤 기기에서 확인한다. 이미지를 바꾸는 결정은 실제 기기 캡처를 사람 앞에 둔다. 리뷰의 「측정 우수, 우선순위 약함」은 업계 좌표에 가깝다. shadow bounds와 결정적 리플레이가 이번 라운드의 내구 자산이다.
실행 가능한 점검표는 짧아 인디·휴대 이식 반복에 바로 붙일 수 있다.
- 프레임 예산과 제약 자원을 적어라. 듀얼 스크린 60 Hz는 프레임당 ≤16.667 ms, 단일 코어 ≤13.33M GPU 사이클. 먼저 포화가 기하인지 프래그먼트인지 프레젠테이션 대기인지 확인한다.
- 지표는 누락 리프레시 비율 또는 긴 프레임 비중을 평균 옆에 둔다. 프레젠테이션 정박에서는 초과가 다음 박자를 통째로 잃는 경우가 많다.
- 기하 운명표를 만들어라. 제출, 샘플 미커버, 근원, 후면, 가시. 내부 화소로 삼각형/픽셀을 낸다. 안개 만에서도 그리는 메시를 가장 먼저 의한다.
- 이미지 불변 후보는 문서 승격. 서명, 체크포인트 바이트 일치, ABBA, GL 오류 없음. 논증은 맞지만 모든 프래그먼트의 최장 경로를 늘리는 분기는 거부한다.
- 이미지 변경은 기기 나란히 캡처만으로 주인이 결정한다. Falllinie는 60 m LOD로 제출 삼각형 약 64% 감소·GPU 약 30% 감소, 창 픽셀 0.6%~1.4% 변경과 바꾸어, 여유를 2.667× 모아레를 죽이는 정확한 2×에 썼다.
- 합격은 오디오 포함 긴 실기 세션으로. 무음 짧은 리플레이는 대조에만 쓴다. 110초 세 번, 19,605프레임, 영 누락. 그것이 Ports의 Falllinie 한 줄 밑바닥이다.
단일 코어는 샘플을 덮지 못하는 삼각형을 용서하지 않는다. 먼저 셌는지, 바운드·컬링·인덱스 또는 먼 사면을 솎는 거리 중 어디에 칼을 떨어뜨렸는지만 본다. 정확한 두 배 확대는 3-3-2 텍셀 주기가 패널 비율에 쓰인 뒤에도 말이 되는, 유일한 선명도 구매다.
