携帯機移植の定番物語が「解像度を下げ、エフェクトを消し、手持ち向けに最適化したと書く」で止まりがちなら、2026年10月14日の夜に Anbernic RG DS Plus で起きた出来事は、同じ一文を別の文法で書き直している。ブラウザのスノーボードゲーム Falllinie のネイティブ C++/OpenGL ES 移植は、双 1024×768 パネル、ROCKNIX と Sway の上で動く。実機プレイではおよそ十三回のリフレッシュに一度欠落していた。その夜の終わりには、毎回のリフレッシュを守り、内部解像度をより鋭い 512×384 に上げたリリースビルドが Ports メニューに並んだ。
本稿を貫くイメージは、遠斜面でどのサンプル点も覆わない三角形だ。冗談に聞こえるが、この単コア Mali-G52 が実際に払っていた勘定である。投入された三角形のうち約五割九分はピクセルサンプルを一つも覆わない。0.8 m ごとに並ぶ地形行は、掠め角ではサブピクセルの破片に縮み、それでも幾何フェーズを埋め尽くす。以下の数字、合格規則、否決された近道は、すべてその事実のまわりを回る。
公開された二本の工学ノートを突き合わせた。その夜の深掘り報告と、前日の性能レビューだ。カウンタ、リプレイ署名、合格表は十分に硬い。以下は検証可能な事実だけを書き、端末ログにない場面は足さない。
一、16.667 ミリ秒、欠落リフレッシュが丸ごと空白になる仕組み
予算はハードウェアに書いてある。RK3568 は Cortex-A55 四基、GPU は Mali-G52 の**一つの**シェーダコア、800 MHz、およそ 975 MiB RAM、スワップなし。両 1024×768 パネルは各 60 Hz でリフレッシュし、上下両画面へ毎フレーム新しい絵を渡さねばならない。フレーム周期は約 16.667 ms。その窓の中で GPU が動ける上限は
800 × 10^6 cycles/s × 16.667 ms = 13.33 × 10^6 cycles.
各ビューは三つの GPU パスを走らせる。シーンパスが地形・物体・ライダー・パーティクルを小さなオフスクリーンへ描き、プリントパスが符号化画像を網点・インク輪郭・手続き空へ変え、出力パスが結果を 1024×768 窓へコピーして HUD を重ねる。単一メインスレッドがすべてを発行し、両窓を Sway に渡す。上画面は三人称、下画面は一人称。一つのコアが二組の幾何とフラグメントを食う。
最初、「遅い」は連続的なフレーム落ちに読まれやすい。計測は別の形を示した。実機オートプレイに音声を乗せると平均間隔は約 17.88 ms、≥25 ms のフレームが 7.6%、p95 は約 27.8 ms。レビューが多数の `frames.csv` を分解すると、平均間隔はほぼ 16.667 ms に、遅れたフレームごとのリフレッシュ一段分を足した値になる。この端末のフレーム時間は、欠落リフレッシュ回数のカウントに近い。一度の超過が次の拍を丸ごと落とすことが多い。拍は表示リフレッシュと窓バッファ取得に縛られ、swap 自体は約 0.3 ms で済む。
後に明示クリアで待ちを釘付けした。ある窓の最初のフレームバッファ操作で、壁時計は約 9.5 ms、メインスレッド CPU は 0.5 ms 未満。どちらが長く待つかはセッションの位相で変わる。最適化の的も変わる。平均が綺麗でも足りない。プレイヤーが見るのは欠落リフレッシュの割合だ。残り余裕より小さい節約は飽和中ほぼ見えず、フレーム全体がリフレッシュ窓に入った瞬間、同じ節約が長フレームを一気に消す。
木、レール、パーティクル、関節ライダー、残響付き音声を足した統合版はおよそ 50 FPS、中央ループ間隔約 19.8 ms だった。以前のプレイ可能ポートは機能を絞った 384×288 で 60 を保てた。目標ははっきりしている。60 を取り戻し、視覚と音声の忠実度は手放さない。リポジトリ規則は元シェーダ本文を硬制約とし、適応はすべて明示登録する。
二、幾何の運命、五万九千個の三角形がゼロピクセルになる理由
初期調査はすでに三つの事実を持っていたが、長いあいだ一つの診断に溶接されなかった。GPU-active はほぼクロックと等しく、フラグメント活性はその約九割九分に存在し、メインスレッド CPU はフレーム予算を大きく下回る。合わせると GPU 飽和だ。そのあと全てを決めた問いは、飽和が何を食っているかだった。
出荷サイズのリプレイで、幾何カウンタは硬い表を出した。ループフレームあたり両ビュー合算で、投入プリミティブ約 424,955、サンプル非カバー約 251,571、近遠外約 84,813、背面または側面外約 22,243、可視約 66,328。位置シェーダスレッド約 447,477、完全 varying 約 76,585。非フラグメント活性約 7.21 M、GPU-active 約 13.95 M。およそ六割の三角形はピクセルを産まず、幾何は活性時間の約半分を占める。
源は地形メッシュだ。斜面方向に 0.8 m ごと一行、各行 107 列。約 110 m のセルは約 29,256 三角形。常駐七セル、ライダー後方一・前方五。地形だけで一ビュー約二十万五千三角形、384×288 の内部画素 110,592 に対し約 1.85 三角形/画素。霧は 400 m で飽和するのに、描画は前方約 660 m まで伸びる。遠行は掠め角で画素破片に縮み、タイルベース GPU はなお位置シェーディング・組み立て・破棄を払う。単コアでは幾何とフラグメントが同じ実行器を奪い合う。サブピクセル三角形はクアッド過剰シェーディングも引き込む。遠斜面でサンプルを覆わない五割九分の三角形が、単コア請求書で最も高い沈黙である。
レビューは率直だ。計測規律は優秀、優先順位は弱い。幾何密度と「霧は満なのにまだ描く」は遅くなってから名指しされた。インディー携帯移植にとって、その一文は叱責より業界座標に近い。問いを間違えた精密機器はカレンダーを埋めるだけだ。決定的データは、しばしば安い実験と正しい問いに向けた一組のカウンタから来る。より綺麗なプローブを選ぶ前に、制約資源を名指せ。
三、画像を変えない四刀、そして否決された一道具
画像不変の最適化には文書化された昇格規則があった。フラグから始め、リプレイ署名不変、五チェックポイント八枚がバイト一致、ABBA で遅くならない、GL エラーなしで計測完全。本報告の全リプレイ署名は `6081555844518115723`。画素を一つでも変えるなら、端末の並びキャプチャをプロジェクト主へ渡し、黙ってデフォルトへ混ぜない。
第一刀はシャドウバウンド。シーンシェーダは各地形フラグメントに対し、ライダー胴体とボードの三段 ray-to-segment 影を評価する。保守的テストは光線方向へ二次元座標へ投影し、ライダー区間を囲み、囲み内だけで元ループを走らせる。出荷 384×288 リプレイでは、元影が平均 17.273 ms、p95 20.399、≥25 ms が 3.9%;バウンド後は 16.620 / 17.611 / 0.0%。音声ありでは ≥25 ms が 6.5% から 0.5% へ。バウンド単独で出荷構成を 60 Hz に入れた。GPU はほぼ満杯、余裕はほぼゼロ。飽和時、フレームあたり活性サイクルはクロック÷フレームレートに過ぎず、節約は別の場所で測る。
第二刀は行ブロックカリング。地形インデックスは行単位なので、連続 16 行(約 12.8 m)は連続インデックス範囲になる。各ブロックは参照頂点の AABB を持つ。描画前に八角をクリップ空間へ変換し、八点が同じ半空間の外に揃えばブロックを飛ばす。クリップ座標は位置に対し線形で、箱内の点は角の凸結合だ。角がすべてある半空間の外なら箱内も外。ブロック内の三角形はフラグメントを産めないので、描画を飛ばしても画像は変わらない。残りは元順のままできるだけ少ないドローにまとめる。CPU テストは同じ浮動式で約 778 万点、19,460 個の却下箱を検証した。110 m セル丸ごとのカリングはほぼ効かない。セルが広すぎて両ビューにほぼ必ず交わるからだ。
第三刀は 16 ビットインデックス。一セル 14,873 頂点なのでインデックスは 16 ビットに収まる。アップロード時に狭め、値と順序は変えず、インデックス通信量を半減する。動的メッシュ、ライダー、多セル静的フィクスチャは 32 ビットのまま。
第四は計測だ。出力パス先頭のクリアを独立計時に入れると、約 9.5 ms の壁時計待ちはバッファ取得として固定され、「描画が遅い」という曖昧さに混ざらない。swap は約 0.3 ms。交換間隔 0 でも、ループは窓への最初の描画でのバッファ取得に拍を合わせる。
論証も成立し画像もバイト一致なのに否決された一道具がある。霧は 400 m で定数出力を書く。完全霧化ブロックは短絡シェーダで描けるはずだった。オフラインコンパイラは、追加分岐が最長算術パスを 11.03 から 11.20 へ伸ばし、全フラグメントが遅くなり、得をするのは薄い遠帯だけだと示した。512×384 では平均が約 20.571 からより悪い 20.712 へ。近道は opt-in のまま否決記録された。綺麗な証明は、長くなった共通パスに勝てない。
三刀がデフォルトになったあと、実機オートプレイ+音声では ≥25 ms が 7.6% から 0.1%、p95 が 27.8 から 17.2 ms へ。GPU はなお約 98% 忙しい。画像不変の刀は出荷サイズを予算縁まで押し上げ、より鋭い内部解像度を買う余裕はほとんど残さなかった。
四、画像を変える一刀、余力を正確二倍へ使う
カリングは最大コストに触れない。画面上にあるがサンプルより小さい三角形は、遠景の詳細を下げて初めて消える。設計は変更をできるだけ小さく、安全に抑える。
各 16 行ブロックで距離に応じ LOD を選ぶ。レベル L は 2^L 行ごとに一行を残し、列は 107 全部。四辺形は元ストリップと同じ二三角形と巻順。ブロックの先頭・末尾行は常にフル列解像度で含め、隣ブロックは境界頂点を共有するので、レベル不一致でも亀裂や T ジャンクションは出ない。近距離 N 以内はフル詳細、外は floor(log2(d/N))+1、上限 4。要素バッファは元インデックスのあとに各ブロックの間引き範囲を置き、同レベル隣接を一つのドローにまとめる。行ブロックカリングと 16 ビットインデックスは継続する。
端末上でフル詳細デフォルトと対照。投入三角形は約 368,600→134,000(約六割四分減)、サンプル非カバー約 252,000→54,500、非フラグメント活性約 5.26 M→2.80 M、外部読取約 21.2 MB→9.2 MB、出荷サイズの GPU 稼働約 99%→約 69%。512×384 双ビューは平均約 20.12 ms・≥25 ms 21.0% から約 16.62 ms・0.0% へ。120 m 近距離は画素変更が少なく GPU 約 77%、節約も少ない。主は並び・スワイプ・差分ページを見て 60 m を選んだ。五チェックポイントで各 1024×768 窓の約 0.6%〜1.4% 画素が変わり、遠稜線とその網点、一部等高線に集中する。
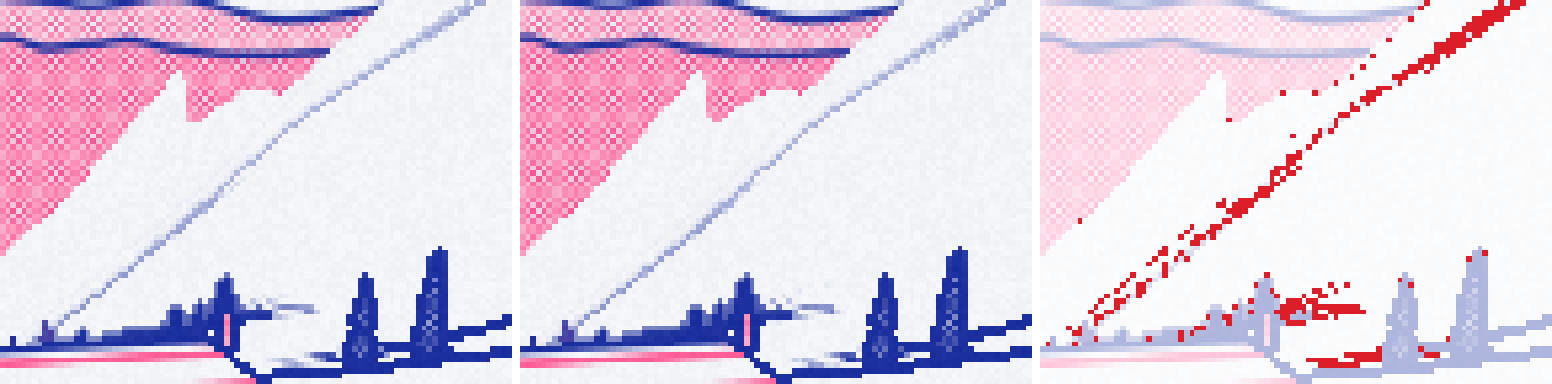
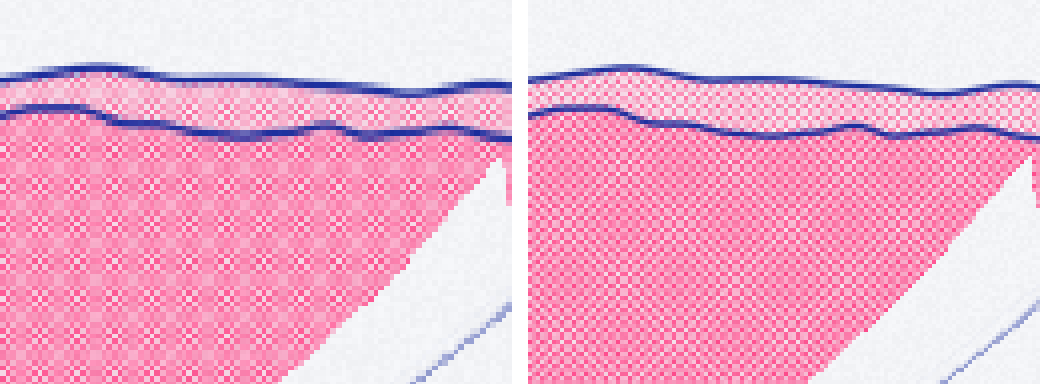
余力はさらなる負荷低下に使われなかった。主は 512×384 に使った。1024×768 に対し正確 2× だ。384×288 の最近傍拡大は 2.667× で、テクセルは 3-3-2 幅の繰り返しになる。プリントシェーダの網点ピッチは約 4.4 画面画素。不均一格子との干渉で半調域に格子模様が現れ、2 画素列を横切る輪郭が粘る。512×384 では各テクセルが 2×2、ピッチ 2.2 テクセルで模様が均等に再現される。出力コピーは画素あたり約一サイクルで安いが、両窓合わせて約 157 万フラグメントスレッド、予算の約一割二分を書く。コピーは残し、HUD 文字はフル窓解像度のまま描く。
60 m 地形と音声では、両内部サイズともリプレイと実機オートプレイで 60 Hz を守り、≥25 ms フレームはゼロ。512×384 は GPU の約九割三、384×288 の約六割九に対する。約 110 秒の実機セッション三本、シード 42・7・1234、合計 19,605 フレーム、**ゼロ**欠落リフレッシュ。平均は 16.667 ms に張り付き、p95 約 16.73〜16.75、最長約 19.75〜21.74 ms、GPU 稼働約 89.5%〜90.6%、ピークメモリ 99〜102 MiB、GL エラーなし、音声アンダーランなし。
リリース既定はシャドウバウンド、行ブロックカリング、16 ビットインデックス、`--terrain-lod 60`、ランチャ `--render-size 512x384`。配備先 `/storage/apps/falllinie-spike`、Ports 名 Falllinie、バイナリ sha256 `7f86667cc49c1aa15e725ee636f8db8f58445f1c79cf7fc6988c980f16363398`、コミット `0bf9969`。旧バイナリは `falllinie-spike.previous`、`mv` 一回でロールバックできる。
結び、単コアの請求書で「最適化」を書き直す
Falllinie を 2026 年の携帯機・インディー移植の現場に戻すと、別種の惰性を打つ。平均が少し悪いのを品質スライダ一段下げと読む人もいれば、飽和 GPU で CPU 投入を削ればフレームが買えると思う人もいる。画像不変の近道は証明が綺麗でも、出荷に値するとは限らない。
この道が示す反例は不器用で硬い。制約資源を名指してから計測器を選ぶ。飽和時は過負荷構成で節約を測る。「投入/可視/理由別カリング」を最も情報量の多い表にする。画像同一性を先に証明し、端末で確認する。画像を変える決定は、本物の端末キャプチャを人の前に置く。レビューの「計測優秀、優先順位弱い」は業界座標に近い。shadow bounds と決定的リプレイが、この回の耐久資産だ。
実行可能なチェックリストは短く、インディー/携帯移植の反復にそのまま貼れる。
- フレーム予算と制約資源を書け。双画面 60 Hz は毎フレーム ≤16.667 ms、単コア ≤13.33M GPU サイクル。まず飽和が幾何かフラグメントか提示待ちかを確認する。
- 指標は欠落リフレッシュ割合または長フレーム比を平均と並べる。提示定拍では超過が次拍を丸ごと落とすことが多い。
- 幾何運命表を作れ。投入、サンプル非カバー、近遠、背面、可視。内部画素で三角形/画素を出す。霧満でも描いているメッシュを最先に疑う。
- 画像不変候補は文書昇格。署名、チェックポイントバイト一致、ABBA、GL エラーなし。論証は正しいが全フラグメントの最長パスを伸ばす分岐は否決する。
- 画像変更は端末並び図だけで主が決める。Falllinie は 60 m LOD で投入三角形約六割四分減・GPU 約三割減、窓画素 0.6%〜1.4% 変更と引き換え、余力を 2.667× モアレを潰す正確 2× に使った。
- 合否は音声付きの長い実機セッションで。無音の短いリプレイは対照に留める。110 秒三本、19,605 フレーム、ゼロ欠落。それが Ports の Falllinie 一行の地面だ。
単コアはサンプルを覆わない三角形を許さない。先に数え、バウンド・カリング・インデックス、あるいは遠斜面を間引く距離のどれに刀を落とすかを決めたかだけを見る。正確二倍拡大は、3-3-2 テクセル周期がパネル比に書き込まれたあと、まだ筋が通る唯一の鋭さの買い方だ。
