如果说掌机移植的默认故事,常常停在「降分辨率、关特效、再写一句已针对手持优化」,那么 2026 年 10 月 14 日晚上发生在 Anbernic RG DS Plus 上的这件事,几乎是在用另一套语法改写同一句话。浏览器滑雪游戏 Falllinie 的原生 C++/OpenGL ES 移植,跑在双 1024×768 面板、ROCKNIX 与 Sway 的栈上。实机游玩时大约每十三次刷新漏一次;当晚结束后,发布构建守住每一次刷新,内部分辨率抬到更锐利的 512×384,并且正式出现在掌机 Ports 菜单里。
贯穿本稿的意象,是远坡上那些盖不住采样点的三角形。它听起来像玩笑,却是这块单核 Mali-G52 在付账的东西。提交进去的三角形里,约五成九盖不住任何一个像素采样点。远坡上每隔 0.8 米就排一行的网格,在掠射视角下缩成亚像素碎屑,却仍然要占满几何阶段的算力。后文的数字、验收规则与那一次被否决的捷径,都围着这件事展开。
我把两份公开工程笔记对过一遍。一份是当晚的完整深潜报告,一份是前一天的性能复盘。���料里的计数器、重放签名与验收表足够硬,下面只写能核验的事实,不补设备上没写过的场面。
一、十六点六六七毫秒,漏刷新怎样变成整段空白
这台机器的预算写在硬件上。RK3568 带四颗 Cortex-A55,GPU 是 Mali-G52,**一个**着色器核心,时钟 800 MHz,大约 975 MiB 内存且无交换分区。两块 1024×768 面板各以 60 Hz 刷新,游戏必须为上下两屏每帧各交一份新画面。帧周期约 16.667 毫秒。同一窗口里,GPU 最多能动用
800 × 10^6 cycles/s × 16.667 ms = 13.33 × 10^6 cycles.
每个视图跑三趟 GPU 通道。场景通道把地形、物件、骑手与粒子画进小离屏图;印刷通道把编码图变成网点、墨线与程序天空;输出通道再把结果拷到 1024×768 窗口并叠 HUD。单主线程发完命令,把两扇窗口交给 Sway。上屏第三人称,下屏第一人称,同一颗核要吃完两套几何与片元。
一开始,慢很容易被读成连续掉帧。实测更像另一种形状。实机自动游玩加音频启动后,平均帧间隔约 17.88 毫秒,7.6% 的帧 ≥25 毫秒,p95 约 27.8 毫秒。复盘把多份 `frames.csv` 拆开后看出,平均间隔几乎等于 16.667 毫秒,再加上每一次迟到帧对应的一整段刷新。帧时间在这台设备上,更接近漏刷新次数的计数。一次超时,往往整段丢掉下一拍。节拍由显示刷新与窗口缓冲拿取卡住,换页调用本身大约只要 0.3 毫秒。
后续用显式清屏把等待钉死。某一扇窗口第一次帧缓冲操作上,墙钟大约 9.5 毫秒,主线程 CPU 却不到 0.5 毫秒。哪一扇窗等得久,会随会话相位偏移。于是优化的靶心也要改。均值好看不够。玩家看得见的,是漏刷新份额。省下不到剩余裕度的一毫秒,在仍饱和时几乎看不见;一旦整帧塞进刷新窗,同一笔节省会突然把长帧份额打掉。
集成玩法把树、栏杆、粒子、关节骑手与带混响的音频加进来之后,大约落在 50 FPS,中位环间隔约 19.8 毫秒。可玩端口在更小功能集上,曾于 384×288 稳住过 60。目标写得很死。找回 60,同时保住视觉与音频保真度。仓库规则把原着色器正文当硬约束,每处适配都要显式登记。
二、几何命运,五万九千个三角形怎样等于零像素
早期调查手里其实已经有三块事实,只是很久没被焊成一句诊断。GPU-active 约等于时钟;片元活跃约占那段时间的九成九;主线程 CPU 远低于帧预算。合起来,GPU 饱和。接下来真正卡住后路的问题,是饱和在吃什么。
在发货尺寸的重放里,几何计数器给出一张极硬的表。每环帧、双视图合计,提交图元约 424,955;盖不住采样点约 251,571;近远裁剪外约 84,813;背向或侧平面外约 22,243;到达光栅的约 66,328。位置着色线程约 447,477,完整 varying 着色约 76,585。非片元活跃周期约 7.21 M,对上约 13.95 M 的 GPU-active。大约六成三角形从不产出像素,几何阶段约占活跃时间一半。
源头在地形网格。坡向每 0.8 米一行,每行 107 列;约 110 米的一格大约 29,256 个三角形;常驻七格,一格在骑手身后、五格在前方。单视图仅地形就大约二十万五千个三角形,对照 384×288 的 110,592 个内部像素,约 1.85 个三角形/像素。雾在 400 米处已满,绘制却仍伸到前方约 660 米。远处行在掠射角下缩成像素碎片,tile-based GPU 仍要为它们付位置着色、装配与丢弃。单核上,几何与片元抢同一套执行单元。亚像素三角形还会拖进四元组过度着色。远坡那五成九盖不住采样的三角形,正是单核账单上最贵的沉默项。
复盘写得很直。测量纪律优秀,优先级偏弱,几何密度与「雾已满却仍在画」很晚才被正面点名。对独立掌机移植,这句话的坐标意义大于责备。精密仪器若问错问题,只会把日历填满。决定性数据,往往来自便宜实验与一套对准正确问题的计数器。命名限制资源,先于挑选更华丽的探针。
三、图像不变的四刀,以及一刀被否决的捷径
图像不变优化有一条晋升规则。命令行开关起步;重放签名不变;五个检查点八张图逐字节相同;ABBA 不更慢;无 GL 错误且测量完整。签名在本报告全部重放里固定为 `6081555844518115723`。改任何一个像素,就拿并排设备截图去找项目主人,禁止偷偷混进默认。
第一刀是阴影包围。场景着色器对每个地形片元做三段骑手身体与滑板的 ray-to-segment 阴影。保守测试沿光线方向投影到二维坐标,框住骑手段,只在框内跑原循环。发货 384×288 重放里,原阴影均值 17.273 毫秒、p95 20.399、≥25 毫秒占 3.9%;开包围后 16.620 / 17.611 / 0.0%。音频开着时,≥25 毫秒从 6.5% 落到 0.5%。阴影包围单独就把发货配置送进 60 Hz。GPU 仍约满负荷,裕度接近零。饱和时,每帧活跃周期只是时钟除以帧率,省下的活要换地方量。
第二刀是行块剔除。地形索引按行写,连续 16 行(约 12.8 米坡)是一段连续索引。每块存引用顶点的 AABB。绘制前把八个角点变到裁剪空间。若八点同落在同一个半空间外,整块跳过。裁剪坐标对位置线性,盒内任一点是角点的凸组合。角点都在半空间外,盒内点也在外。块内三角形产不出片元,跳过绘制不改图像。剩余块按原序尽量并成更少次绘制。CPU 测试用同一表达式浮点核算了约 778 万采样点、19,460 个被拒盒。整格 110 米宽的剔除几乎没用,因为格子太宽,几乎总与两视图相交。
第三刀是 16 位索引。一格 14,873 个顶点,索引装进 16 位。上传时收窄,值与顺序不变,索引流量减半。动态网格、骑手与多格静态夹具仍用 32 位。
第四项其实是测量。把输出通道开头的清屏放进独立计时后,那约 9.5 毫秒的墙钟等待被钉成缓冲获取,不再混进「渲染很慢」的笼统说法。swap 约 0.3 毫秒。环路由首笔窗口绘制上的缓冲获取定拍,即便交换间隔为 0。
有一刀论证成立、图像也字节相同,却被否决。雾在 400 米处写死常量输出,完全雾化块本可用短路着色器。线下编译器显示,额外分支把最长算术路径从 11.03 拉到 11.20,所有片元一起变慢,只有薄薄一条远带受益。512×384 上均值从约 20.571 落到更差的 20.712。捷径留作可选,记入否决。漂亮论证挡不住更长的公共路径。
三刀进默认后,实机自动游玩加音频,≥25 毫秒从 7.6% 降到 0.1%,p95 从 27.8 到 17.2 毫秒。GPU 仍约 98% 忙碌。图像不变的刀,已经把发货尺寸顶到预算边缘,却几乎没留下余量去买更锐的内部分辨率。
四、改图像的一刀,以及把余量花在精确两倍上
剔除碰不到最大成本。那些已在屏上、却小于采样点的三角形,只能靠降低远处细节拿掉。设计把改动压到尽量小、尽量安全。
对每个 16 行块,按距离选 LOD。级别 L 每隔 2^L 行取一行,列仍全留 107。四边形用与原条带相同的两三角与绕序。块首尾行永远全分辨率纳入,邻块共享边界顶点,级别不一致也不会裂开或出 T 接缝。近距阈值 N 内用全细节;以外取 floor(log2(d/N))+1,封顶 4。元素缓冲先存原索引,再存各块抽稀区间;同级别邻块合并绘制。行块剔除与 16 位索引继续生效。
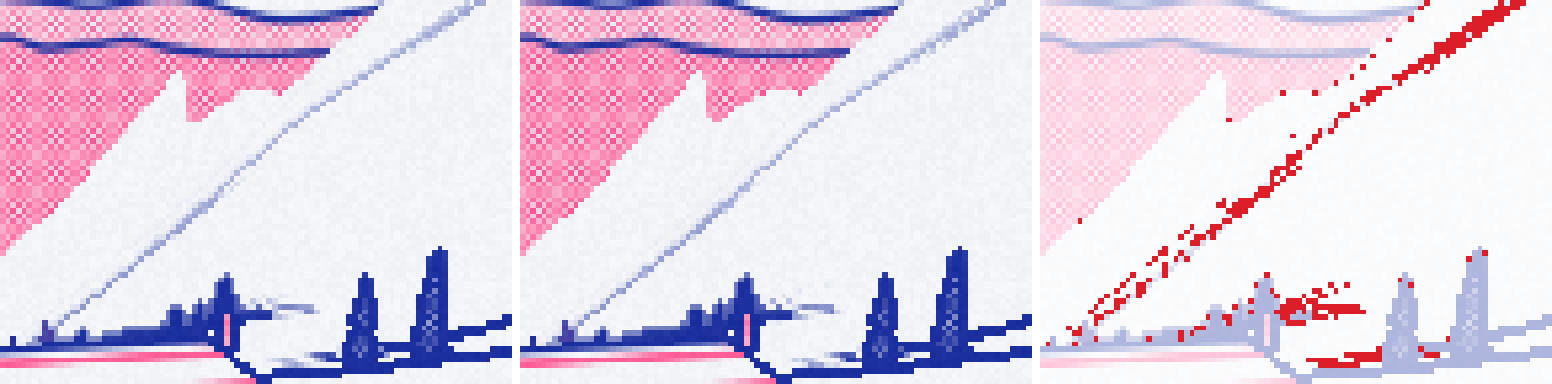
设备上对照全细节默认。提交三角形从约 368,600 降到约 134,000,少约六成四;盖不住采样从约 252,000 降到约 54,500;非片元活跃从约 5.26 M 到约 2.80 M;外部读从约 21.2 MB 到约 9.2 MB;发货尺寸 GPU 忙碌约 99% 降到约 69%。512×384 双视图均值从约 20.12 毫秒、≥25 毫秒 21.0%,落到约 16.62 毫秒、0.0%。120 米近距更省像素改动,GPU 约 77% 忙碌,省得更少。主人看过并排、滑动与差分页后,选了 60 米。五个检查点上,每扇 1024×768 窗改动约 0.6% 到 1.4% 像素,主要落在远脊线、脊上网点与部分等高线。
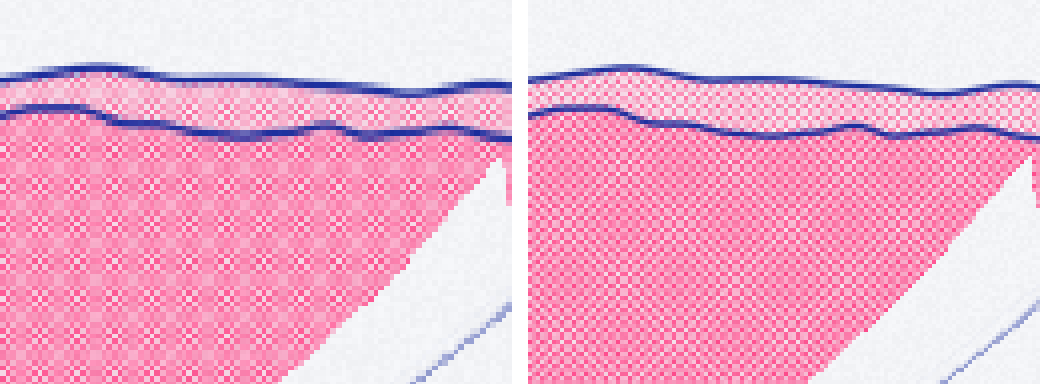
余量没有拿去继续降负载。主人把它花在 512×384。对 1024×768,这是精确 2×。384×288 的最近邻放大是 2.667×,纹素落到屏上呈 3-3-2 宽循环;印刷着色器网点节距约 4.4 屏像素,与不匀网格干涉,半色调区出现方格纹,轮廓过 2 像素列时发粘。512×384 上每纹素成 2×2 块,网点 2.2 纹素,图案均匀复现。输出拷贝本身便宜,每像素大约一周期,但两扇窗合计写满约 157 万片元线程,约占预算一成二。拷贝留下,HUD 仍全分辨率描字。
带 60 米地形与音频,两种内部尺寸在重放与实机自动游玩里都能守 60 Hz,无 ≥25 毫秒帧。512×384 约占 GPU 九成三,对照 384×288 的约六成九。三场各约 110 秒的实机会话,种子 42、7、1234,合计 19,605 帧,**零**次漏刷新;均值贴在 16.667 毫秒;p95 约 16.73 到 16.75;最长约 19.75 到 21.74 毫秒;GPU 忙碌约 89.5% 到 90.6%;峰值内存 99 到 102 MiB;无 GL 错误,无音频欠载。
发布配置写进默认。阴影包围、行块剔除、16 位索引、`--terrain-lod 60`,启动器传 `--render-size 512x384`。部署到 `/storage/apps/falllinie-spike`,Ports 菜单名 Falllinie,二进制 sha256 `7f86667cc49c1aa15e725ee636f8db8f58445f1c79cf7fc6988c980f16363398`,提交 `0bf9969`。旧二进制留作 `falllinie-spike.previous`,一条 `mv` 可回滚。
收束,在单核账单上重写优化二字
把 Falllinie 放回 2026 年的掌机与独立移植现场,它打击的是另一种惰性。有人把均值掉一点直接读成再拧小一档;有人以为饱和 GPU 上省 CPU 提交就能换帧率。图像不变的捷径只要论证漂亮,也未必该上。
这条路径给出的反例很笨,也很硬。先命名限制资源,再选仪器;饱和时到过载配置上量节省;把提交、可见、按原因剔除写成最有信息的表;图像同一性先证明,再上真机核对;改图像的决定,把真实设备截图推到人面前。复盘里那句「测量优秀、优先级偏弱」更像行业坐标。shadow bounds 与确定性重放,是这轮耐用的资产。
可执行的提示很短,却够独立与掌机移植直接抄进迭代。
- 写下你的帧预算与限制资源。双屏 60 Hz 就是每帧 ≤16.667 毫秒、单核 ≤13.33M GPU 周期;先确认饱和在几何、片元还是呈现等待。
- 指标改成漏刷新份额或长帧占比,并排均值。呈现定拍时,超时往往整段丢掉下一拍。
- 拉一张几何命运表。提交数、无采样覆盖、近远裁、背向、可见;对照内部像素算三角形/像素。远雾已满仍在画的网格,优先进嫌疑名单。
- 图像不变候选走书面晋升。签名、检查点逐字节、ABBA、无 GL 错误。论证成立却让最长路径变长的分支,勇敢否决。
- 图像改动只拿并排设备图做主人决策。Falllinie 用 60 米 LOD 换约六成四提交三角形、约三成 GPU,改 0.6% 到 1.4% 窗像素,再把余量花在消灭 2.667× 莫尔纹的精确 2× 上。
- 验收用带音频的实机长会话,静音短重放只能当对照。三场 110 秒、19,605 帧、零漏刷新,才是 Ports 菜单里那一行 Falllinie 的底气。
单核不会原谅盖不住采样的三角形。它只认你有没有先数清它们,再决定刀落在包围、剔除、索引,还是那一刀改远坡细节的距离。精确两倍放大,是 3-3-2 纹素循环被写进面板比例之后,唯一还说得通的锐度买法。
