Si la historia por defecto de los ports a portátil suele detenerse en «bajar resolución, apagar efectos y escribir que está optimizado para mano», lo que ocurrió la noche del 14 de octubre de 2026 en un Anbernic RG DS Plus casi reescribe esa frase con otra gramática. Falllinie, un port nativo C++/OpenGL ES de un juego de snowboard del navegador, corre en dos paneles 1024×768 bajo ROCKNIX y Sway. En juego real perdía aproximadamente un refresco de cada trece. Al final de esa noche, el build de lanzamiento sostenía cada refresco, subía la resolución interna a un 512×384 más nítido y aparecía en el menú Ports de la portátil.
La imagen que atraviesa este texto es el triángulo de la ladera lejana que no cubre ninguna muestra. Suena a broma, pero es lo que pagaba este Mali-G52 de un solo núcleo. Alrededor del cincuenta y nueve por ciento de los triángulos enviados no cubría ninguna muestra de píxel. Filas de terreno cada 0,8 m se encogen en restos subpíxel en ángulos rasantes y aun así llenan la fase de geometría. Los números, las reglas de aceptación y el atajo rechazado que siguen orbitan ese hecho.
Cruce dos notas de ingeniería públicas: el informe profundo de esa noche y la revisión de rendimiento del día anterior. Contadores, firmas de replay y tablas de aceptación son lo bastante duros. Lo que sigue se ciñe a hechos verificables y no inventa escenas que los registros del dispositivo nunca anotaron.
I. 16,667 ms: cómo un refresco perdido se vuelve un silencio entero
El presupuesto está escrito en el hardware. El RK3568 tiene cuatro Cortex-A55; la GPU es un Mali-G52 con **un** núcleo de sombreado a 800 MHz, unos 975 MiB de RAM y sin swap. Ambos paneles 1024×768 refrescan a 60 Hz, así que el juego debe entregar un fotograma nuevo a cada pantalla en cada ciclo. El período es unos 16,667 ms. En esa ventana la GPU puede estar activa como máximo
800 × 10^6 cycles/s × 16.667 ms = 13.33 × 10^6 cycles.
Cada vista corre tres pases GPU. El pase de escena dibuja terreno, objetos, jinete y partículas en una imagen offscreen pequeña; el pase de impresión convierte la imagen codificada en trama, contornos de tinta y cielo procedural; el pase de salida copia el resultado a la ventana 1024×768 y dibuja el HUD. Un solo hilo principal emite todo y entrega ambas ventanas a Sway. Panel superior en tercera persona, inferior en primera: un núcleo come dos juegos de geometría y fragmentos.
Al principio, «lento» se lee con facilidad como caída continua de FPS. La medición tiene otra forma. Autojuego en vivo con audio arrancaba con media de unos 17,88 ms, 7,6% de fotogramas ≥25 ms y p95 de unos 27,8 ms. Tras partir muchos `frames.csv`, la media es casi exactamente 16,667 ms más un refresco completo por cada fotograma tarde. El tiempo de fotograma en este aparato se acerca a un conteo de refrescos perdidos. Un overrun a menudo pierde el siguiente golpe entero. El ritmo lo atan el refresco de pantalla y la adquisición del búfer de ventana; el swap en sí cuesta unos 0,3 ms.
Un clear explícito clavó después la espera. En la primera operación de framebuffer de una ventana, el reloj de pared era unos 9,5 ms y la CPU del hilo principal menos de 0,5 ms. Qué ventana espera más cambia con la fase de la sesión. Hay que cambiar también el blanco de la optimización. Una media bonita no basta. Lo que ve el jugador es la proporción de refrescos perdidos. Un ahorro menor que el margen restante casi no se ve mientras la GPU sigue saturada; cuando el fotograma entero cabe en la ventana de refresco, el mismo ahorro borra de golpe los fotogramas largos.
Tras añadir árboles, raíles, partículas, un jinete articulado y audio con reverberación, el juego integrado se situaba cerca de 50 FPS, con mediana de bucle de unos 19,8 ms. El port jugable anterior había sostenido 60 a 384×288 con menos funciones. El objetivo era seco. Recuperar 60 sin entregar fidelidad visual ni de audio. Las reglas del repositorio tratan los cuerpos originales de los shaders como restricción dura; cada adaptación debe registrarse de forma explícita.
II. Destino geométrico: cómo cincuenta y nueve mil triángulos equivalen a cero píxeles
La investigación temprana ya tenía tres hechos que mucho tiempo no se soldaron en un diagnóstico. GPU-active casi igualaba el reloj; la actividad de fragmentos estaba presente alrededor del noventa y nueve por ciento de ese tiempo; la CPU del hilo principal quedaba muy por debajo del presupuesto. Juntos: GPU saturada. La pregunta que decidió todo después fue qué estaba comiendo esa saturación.
En el tamaño de envío, los contadores de geometría dieron una tabla dura. Por fotograma de bucle, ambas vistas: primitivas enviadas unas 424.955; sin cobertura de muestra unas 251.571; fuera de near/far unas 84.813; orientadas al revés o fuera de planos laterales unas 22.243; visibles unas 66.328. Hilos del shader de posición unos 447.477; varying completo unos 76.585. Ciclos no-fragmento activos unos 7,21 M frente a unos 13,95 M de GPU-active. Unos seis de cada diez triángulos no producen píxel; la geometría ocupa cerca de la mitad del tiempo activo.
La fuente es la malla de terreno. Filas cada 0,8 m pendiente abajo, 107 columnas; una celda de unos 110 m tiene unos 29.256 triángulos; siete celdas residentes, una detrás del jinete y cinco delante. Solo el terreno suma unos 205.000 triángulos por vista frente a 110.592 píxeles internos a 384×288, unos 1,85 triángulos por píxel. La niebla está completa a 400 m, pero el dibujo llega aún a unos 660 m por delante. Las filas lejanas se encogen a restos de píxel en ángulo rasante; una GPU basada en tiles sigue pagando sombreado de posición, ensamblaje y descarte. En un solo núcleo, geometría y fragmentos compiten por el mismo hardware de ejecución. Los triángulos subpíxel también arrastran overshading de quads. Ese cincuenta y nueve por ciento de triángulos sin muestra en la ladera lejana es el silencio más caro de la factura de un núcleo.
La revisión es directa. Disciplina de medición excelente, priorización débil; la densidad geométrica y «niebla completa y aún se dibuja» se nombraron tarde. Para ports indie a portátil, esa frase es más coordenada de industria que reprimenda. Instrumentos precisos apuntados a la pregunta equivocada solo llenan calendarios. Los datos decisivos suelen venir de experimentos baratos y un juego de contadores apuntado a la pregunta correcta. Nombra el recurso limitante antes de elegir una sonda más bonita.
III. Cuatro cortes que no cambian la imagen, y un atajo rechazado
El trabajo que preserva la imagen tenía una regla escrita de promoción. Empezar tras un flag; firma de replay sin cambio; ocho imágenes en cinco puntos de control idénticas byte a byte; no más lento en orden ABBA; sin errores GL y registros completos. Todos los replays de este informe produjeron la firma `6081555844518115723`. Si cambia un píxel, lleva capturas lado a lado al dueño del proyecto; no lo cueles en el valor por defecto.
Primer corte: shadow bounds. El shader de escena evalúa tres términos de sombra ray-to-segment contra el cuerpo y la tabla del jinete en cada fragmento de terreno. Una prueba conservadora proyecta a lo largo de la luz a una coordenada 2D, acota los segmentos del jinete y solo dentro del acotado corre el bucle original. En 384×288 de envío, replay: sombras originales media 17,273 ms, p95 20,399, fotogramas ≥25 ms 3,9%; con bounds 16,620 / 17,611 / 0,0%. Con audio, ≥25 ms cayó de 6,5% a 0,5%. Solo los bounds llevaron la configuración de envío a 60 Hz. La GPU seguía casi llena; margen cerca de cero. Saturada, los ciclos activos por fotograma son solo reloj entre tasa de fotogramas; el ahorro hay que medirlo en otro sitio.
Segundo corte: culling por bloques de filas. Los índices de terreno se escriben fila a fila, así que dieciséis filas seguidas (unos 12,8 m de pendiente) son un rango contiguo. Cada bloque guarda el AABB de sus vértices. Antes de dibujar una vista, los ocho vértices pasan a espacio de clip. Si los ocho quedan fuera del mismo semiespacio, se salta el bloque. Las coordenadas de clip son lineales en la posición; cualquier punto del caja es combinación convexa de las esquinas. Si toda esquina está fuera de un semiespacio, todo el caja también. Ningún triángulo del bloque puede producir fragmento; saltar el draw no cambia la imagen. Los bloques restantes se fusionan en el menor número posible de draws, en orden original. Un test de CPU evaluó la misma expresión en coma flotante sobre unos 7,78 millones de puntos de 19.460 cajas rechazadas. Cullar celdas enteras de 110 m casi no quita nada, porque cada celda es tan ancha que casi siempre corta ambas vistas.
Tercer corte: índices de 16 bits. Una celda tiene 14.873 vértices, así que cada índice cabe en 16 bits. Estrechar al subir mantiene valores y orden e reduce a la mitad el tráfico de índices. Mallas dinámicas, el jinete y el fixture estático multicelda siguen en 32 bits.
El cuarto ítem es medición. Con el clear del pase de salida en su propio ámbito de tiempo, esa espera de ~9,5 ms de pared se clava como adquisición de búfer, ya no mezclada en un vago «el render es lento». El swap cuesta unos 0,3 ms. El bucle lo marca la adquisición en el primer draw a una ventana, aunque el intervalo de swap sea 0.
Un corte tenía argumento sólido e imágenes idénticas byte a byte, y aun así se rechazó. La niebla escribe una constante a 400 m; los bloques totalmente nebulizados podrían usar un shader de cortocircuito. El compilador offline mostró que la rama extra alargaba el camino aritmético más largo de 11,03 a 11,20 para todos los fragmentos, mientras solo se beneficia una franja lejana fina. A 512×384 la media pasó de unos 20,571 a un peor 20,712. El atajo quedó opt-in y se registró como rechazado. Una prueba bonita no gana a un camino común más largo.
Tras promover los tres cortes, el autojuego en vivo con audio vio ≥25 ms caer de 7,6% a 0,1% y p95 de 27,8 a 17,2 ms. La GPU seguía ocupada cerca del 98%. El trabajo que preserva la imagen había empujado el tamaño de envío al borde del presupuesto con casi ningún margen para comprar una resolución interna más nítida.
IV. Un corte que cambia la imagen, y gastar el margen en ×2 exacto
El culling no toca el coste mayor: triángulos en pantalla pero más pequeños que una muestra. Quitarlos implica dibujar el terreno lejano con menos triángulos. El diseño mantiene el cambio lo más pequeño y seguro posible.
Para cada bloque de 16 filas, el LOD se elige por distancia. El nivel L conserva cada 2^L-ésima fila y las 107 columnas. Los quads usan los mismos dos triángulos y winding que las tiras originales. La primera y la última fila del bloque siempre entran a resolución de columnas completa; los vecinos comparten esos vértices de borde, así que niveles distintos no dejan grietas ni T-junctions. Dentro de la distancia cercana N, detalle completo; más allá, floor(log2(d/N))+1, tope 4. El buffer de elementos guarda los índices originales y luego los rangos diezmados; bloques adyacentes del mismo nivel se fusionan en un draw. El culling por bloques y los índices de 16 bits siguen aplicando.
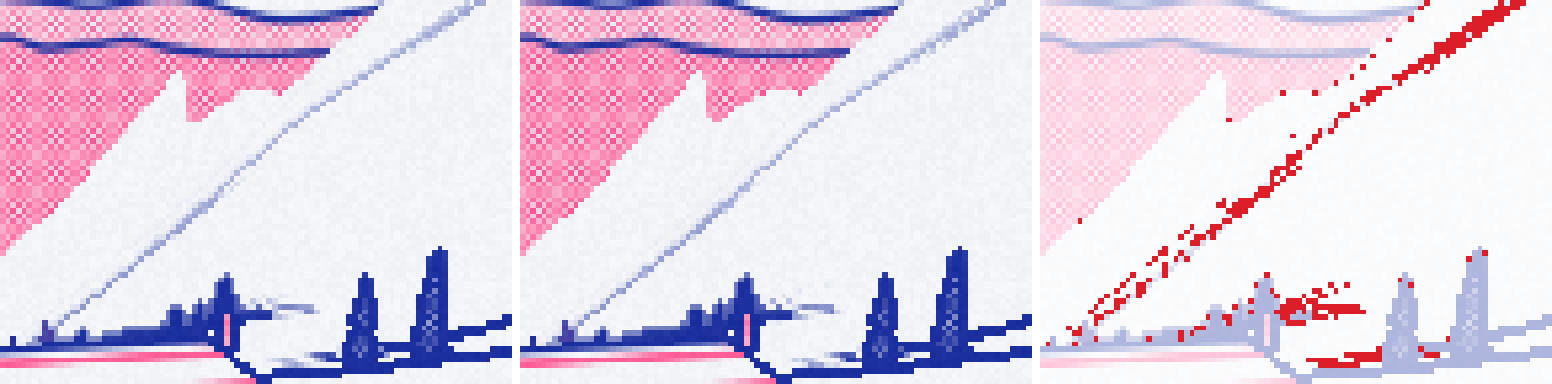
Medido en dispositivo frente a los defaults de detalle completo: triángulos enviados unos 368.600 → 134.000 (−64%); sin muestra unos 252.000 → 54.500; no-fragmento activo unos 5,26 M → 2,80 M; lecturas externas unos 21,2 MB → 9,2 MB; GPU ocupada en tamaño de envío unos 99% → unos 69%. A 512×384 dual, media unos 20,12 ms / 21,0% ≥25 ms bajó a unos 16,62 ms / 0,0%. Una distancia cercana de 120 m cambió menos píxeles y dejó la GPU cerca del 77%, ahorrando menos. El dueño revisó páginas lado a lado, deslizamiento y diferencia y eligió 60 m. En cinco puntos de control, cada ventana 1024×768 cambió entre un 0,6% y un 1,4% de píxeles, concentrados en crestas lejanas, puntos de trama y algunas líneas de contorno.
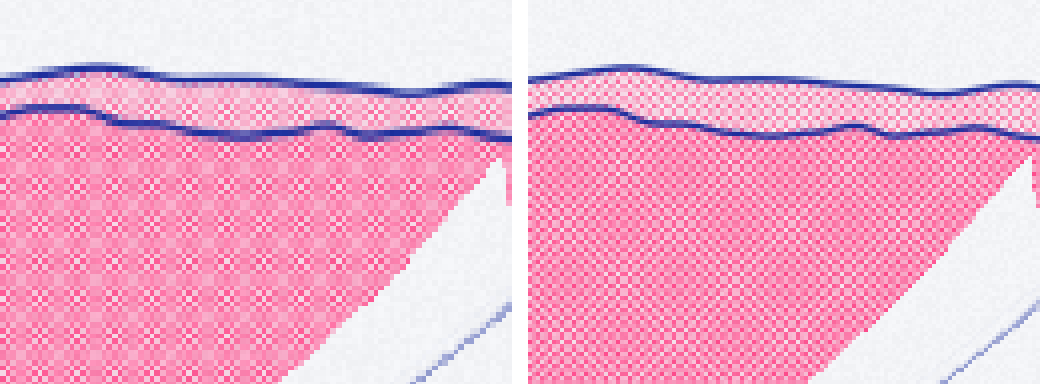
El margen no se gastó en bajar más la carga. El dueño lo gastó en 512×384. Frente a 1024×768 es ×2 exacto. El nearest-neighbour desde 384×288 es 2,667×; los texels caen en un patrón 3-3-2. El pitch de trama del shader de impresión es unos 4,4 píxeles de pantalla; la interferencia con la rejilla irregular hace cuadriculado en zonas de trama y abulta contornos al cruzar columnas de 2 píxeles. A 512×384 cada texel es un bloque 2×2, el pitch es 2,2 texels y el patrón se reproduce de forma pareja. Las copias de salida son baratas por píxel (unos un ciclo) pero grandes: ambas ventanas escriben juntos unos 1,57 millones de hilos de fragmento, cerca del doce por ciento del presupuesto. Las copias se quedan; el HUD sigue dibujándose a resolución completa de ventana.
Con terreno a 60 m y audio, ambos tamaños internos sostienen 60 Hz en replay y autojuego en vivo sin fotogramas ≥25 ms. 512×384 usa cerca del 93% de la GPU frente a unos 69% a 384×288. Tres sesiones en vivo de unos 110 segundos, semillas 42, 7 y 1234, sumaron 19.605 fotogramas con **cero** refrescos perdidos; media pegada a 16,667 ms; p95 unos 16,73 a 16,75; máximo unos 19,75 a 21,74 ms; GPU ocupada unos 89,5% a 90,6%; pico de memoria 99 a 102 MiB; sin errores GL ni underruns de audio.
Defaults de lanzamiento: shadow bounds, culling por bloques, índices de 16 bits, `--terrain-lod 60`, launcher `--render-size 512x384`. Desplegado en `/storage/apps/falllinie-spike`, nombre en Ports Falllinie, sha256 del binario `7f86667cc49c1aa15e725ee636f8db8f58445f1c79cf7fc6988c980f16363398`, commit `0bf9969`. El binario anterior se guarda como `falllinie-spike.previous`; un `mv` hace rollback.
Cierre: reescribir «optimizar» en la factura de un solo núcleo
Vuelve a poner Falllinie en el suelo de ports indie y portátiles de 2026, y golpea otra inercia. Hay quien lee una media un poco peor como «bajar un punto el deslizador de calidad»; quien asume que recortar envío de CPU en una GPU saturada comprará fotogramas. Un atajo que preserva la imagen con una prueba bonita aún puede no merecer el envío.
El contraejemplo de este camino es torpe y duro. Nombra el recurso limitante antes de elegir el instrumento; mide el ahorro en una configuración sobrecargada cuando la GPU está saturada; haz de «enviados / visibles / culled por motivo» la tabla más informativa; demuestra identidad de imagen y luego compruébala en el dispositivo; pon las decisiones que cambian la imagen delante de una persona con capturas reales. La línea de la revisión «excelente medición, priorización débil» se lee más como coordenada de industria. Shadow bounds y el replay determinista son los activos durables de esta ronda.
La lista ejecutable es lo bastante corta para pegarla en una iteración indie o de portátil.
- Escribe tu presupuesto de fotograma y el recurso limitante. Doble pantalla a 60 Hz es ≤16,667 ms por fotograma y ≤13,33M ciclos GPU en un núcleo; confirma primero si la saturación es geometría, fragmentos o espera de presentación.
- Informa la proporción de refrescos perdidos o de fotogramas largos junto a la media. Bajo ritmo de presentación, un overrun a menudo pierde el siguiente golpe entero.
- Monta una tabla de destino geométrico: enviados, sin muestra, near/far, facing, visibles; divide por píxeles internos. Las mallas que aún se dibujan pasada la niebla completa van primero a la lista de sospechosos.
- Promueve candidatos que preservan imagen con regla escrita: firma, puntos de control idénticos, ABBA, sin errores GL. Rechaza ramas cuyo argumento es sólido pero alargan el camino más largo para todos los fragmentos.
- Decide cambios de imagen solo con capturas lado a lado del dispositivo. Falllinie canjeó LOD a 60 m por unos −64% de triángulos enviados y unos −30% de GPU, cambiando 0,6% a 1,4% de píxeles de ventana, y gastó el margen en matar el moiré 2,667× con ×2 exacto.
- Acepta con sesiones largas en vivo que incluyan audio; los replays cortos silenciados solo sirven de control. Tres corridas de 110 segundos, 19.605 fotogramas, cero refrescos perdidos: ese es el suelo bajo la línea Falllinie del menú Ports.
Un solo núcleo no perdona triángulos que no cubren muestra. Solo pregunta si los contaste primero y luego elegiste el corte entre bounds, culling, índices o la distancia que adelgaza la ladera lejana. El escalado exacto ×2 es la única compra de nitidez que aún tiene sentido cuando un ciclo de texels 3-3-2 está escrito en la proporción del panel.
