Si el valor por defecto de la industria para correr un reino vivo en el navegador suele ser «primero que se vea bien; cuando tire, baja sombras, corta el lejos, deja que el LOD cambie de golpe delante de la cámara y escribe en la nota de prensa que está optimizado para móvil», entonces el 18 de octubre de 2026 el ensayo de Esteban Estrada *Invisible Wins: 60 FPS for a Whole Kingdom, Even on a Phone*, publicado en codestz.dev, casi reescribe esa factura en público. La obra se llama Guildhall. Corre en una pestaña WebGL. El objetivo es directo: sostener 60 en un M1 Pro y que vaya fluido en el teléfono. Este texto no jugó a fondo el producto terminado; las escenas y cifras siguientes vienen de las notas públicas del autor y del demo en vivo.
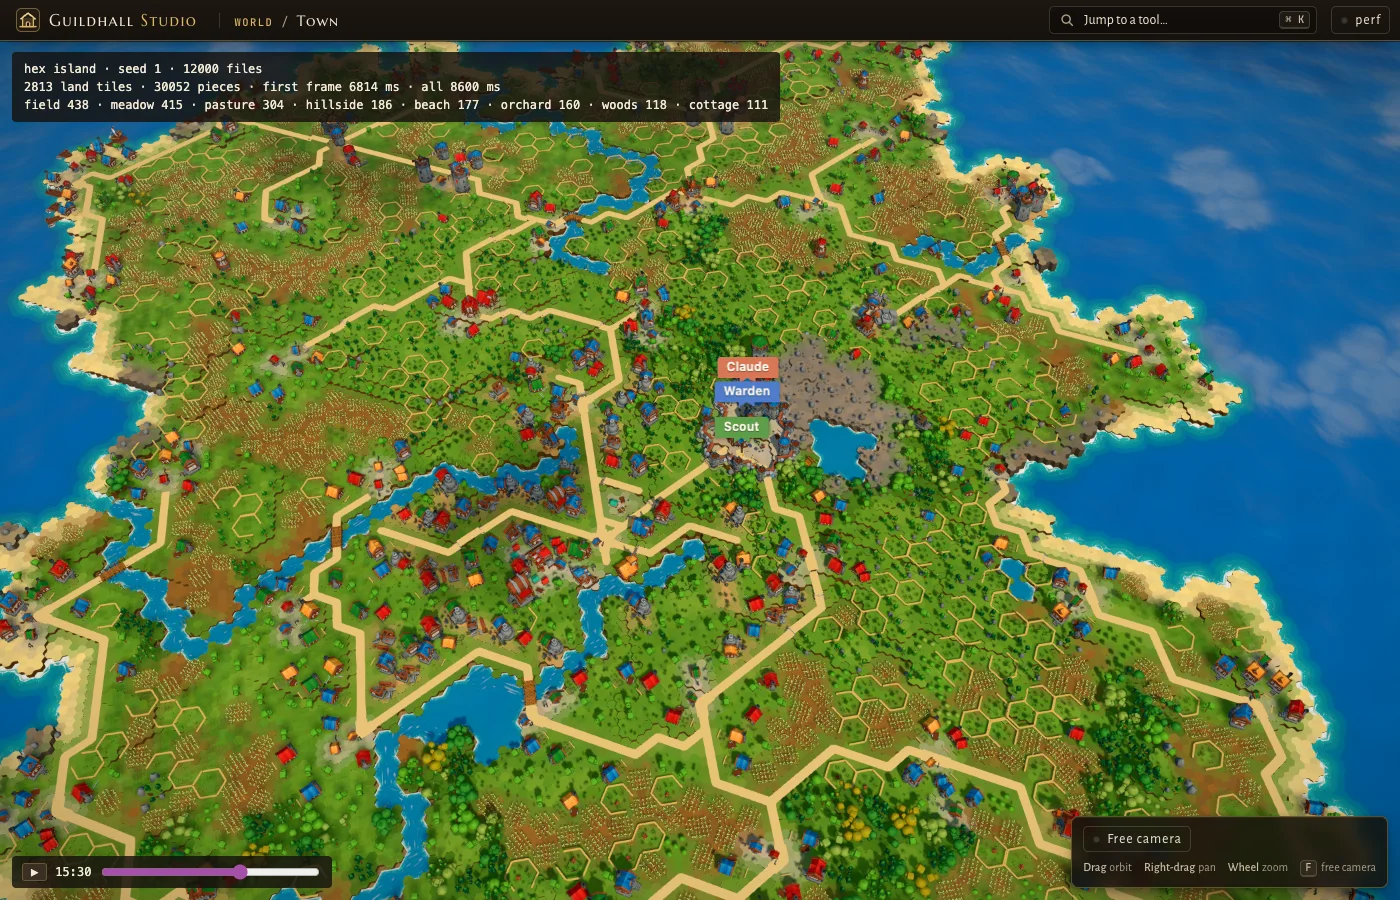
Una isla de 12.000 archivos se convierte en 2.813 baldosas de tierra y unas 30.052 piezas: casas, árboles, vallas, cultivos, un castillo. Encima hay multitudes con rutinas diarias, un mar con olas, un cielo y un sol que gira el día y arrastra todas las sombras. No es un demo de «si abre, ganamos». La línea que Estrada escribió en el archivo de decisiones el 12 de octubre de 2026 es más dura que cualquier eslogan de fotogramas: *Performance must not change what you see* — el rendimiento no debe cambiar lo que ves.
La imagen que atraviesa este texto es el look sheet, y lo «invisible». Suena a nombre de herramienta de QA. Como ética de producción es una promesa verificable: primero que la imagen cuadre a nivel de píxel; luego hablar de qué tijeretazo ahorró tiempo. Lo ahorrado debe dejar un libro mayor. Lo que cambia es el coste. El reino en el lente sigue siendo idéntico byte a byte.
1. Lógica por defecto: optimizar es cambiar la imagen; bastan los FPS para ganar
La lógica por defecto de la industria es limpia y, por eso, perezosa.
Cuando un proyecto 3D web baja del escritorio al teléfono, el equipo suele abrir un menú familiar: bajar el device pixel ratio, acortar la distancia de sombras, apagar cascadas, cambiar mallas lejanas por cascos toscos, reducir a la mitad el postproceso que «parece caro». Los jugadores aprenden el mismo vocabulario — «aceptable», «el lejos puede ir blando», «en el móvil el medio basta». Ese pacto convierte el downgrade visible en gramática industrial perdonable.
Guildhall encaja mal en esa gramática: escala de isla entera, sombras día-noche que giran con el sol, horarios de multitud, programas de clima y espectáculos, y aún así 60 fps dentro de una pestaña. El presupuesto apunta a «todo un reino». El instinto industrial apunta casi solo a «cambiar el lejos, engrosar sombras, dejar que el LOD salte al hacer zoom».
La V1 cayó en esa trampa. Al acercar y alejar, el mundo se intercambiaba a la vista: cosas saltaban; cada distancia tenía un aspecto ligeramente distinto. Así que antes de cualquier commit de rendimiento Estrada clavó la regla. Esa línea hizo el trabajo mucho más duro y mucho mejor. Un cambio solo contaba si era invisible. Para probar «invisible» hacen falta números e imágenes, no opiniones — incluidas las suyas.
La bifurcación está aquí. El valor por defecto pregunta qué aspecto cortar cuando fallan los FPS. Ellos preguntan qué implementaciones deben volverse más baratas sin dejar de ser idénticas byte a byte en pantalla — y cuáles «victorias seguras» deben devolver las mediciones.
2. Romper el guion: un protocolo de laboratorio, y la máquina antes de la escena
El rendimiento es fácil de afirmar y difícil de probar. Una idea que suena a victoria segura a menudo no lo es. Estrada entró con una lista de experiencia: niveles de detalle, sombras cacheadas, sombras lejanas más ligeras, macro-cáscaras para clústeres lejanos, sacar a la multitud de las sombras lejanas, descartar proyectores de sombra minúsculos, agua lejana más barata. Cada ítem es una técnica real. Pero una lista solo es una lista de conjeturas. Algunas ganan, otras casi no cuestan, otras cambian en silencio lo que ves.
Así que antes de optimizar escribió el contrato y el plan, entregó las pasadas largas de medición e implementación a un modelo más grande, Fable 5.1, ejecutando ese plan, y decidió qué entraba. El contrato se lee más como protocolo de laboratorio que como ticket: seis poses fijas de cámara — héroe, media, ancha, faroles a las 19:30, plaza a mediodía ocupada, bajo sobre el mar — en 4.000 y 12.000 archivos, tres corridas cada una, sin nada más en marcha. Un libro mayor: cada cambio añade before → after por pose; una ganancia menor que el ruido medido se revierte. Invariantes que bloquean: look sheet (5 zooms × varias horas, antes vs después), barrido de zoom sin pops, sombras nunca viejas ni saltando. Una técnica por commit, cada una con sus números. Máquina quieta, dispositivo real, checkpoint humano: sin otros navegadores durante el bench; chequeo en teléfono real; él ve el libro y los look sheets a mitad; al final un agente que no escribió el código vuelve a correrlo todo.
Lo primero que midió no fue un shader lento. Fue la máquina.
Los temporizadores GPU del Mac mienten. En ANGLE sobre Metal, `EXT_disjoint_timer_query_webgl2` lee el tiempo de pared de cada command buffer, tarda 20–30 fotogramas en resolverse y cuesta unos 1,3 ms por fotograma por sí solo. Los temporizadores pasaron a ser opcionales; el coste se midió por resta. Una pestaña ocupada triplica los tiempos de fotograma. Un bench «tranquilo» leía cada pose a unos 34 ms; su propio Chrome aún tenía una pestaña Guildhall viva, proceso GPU al 9–18% de CPU. Cerrada, el mismo commit leía 9,7 / 12,2 ms (p50 / p95). Nada había regresado. Un teléfono podía batir al portátil: en su Xiaomi la isla iba por encima de 60 mientras el Mac se sentía más lento, porque los headless de los agentes compartían la GPU. Desde entonces cada bench comprueba `ps` por otros navegadores y lo anota en el libro.
Esa es la clase de regla que da la experiencia: antes de optimizar la escena, aísla la máquina. Si no, optimizas ruido.
3. Cortes concretos en el presupuesto del fotograma: instancias, sombras, shaders, workers, bytes
Adónde va un fotograma, Estrada lo abre en el orden que importó. Cada caja es una lección.
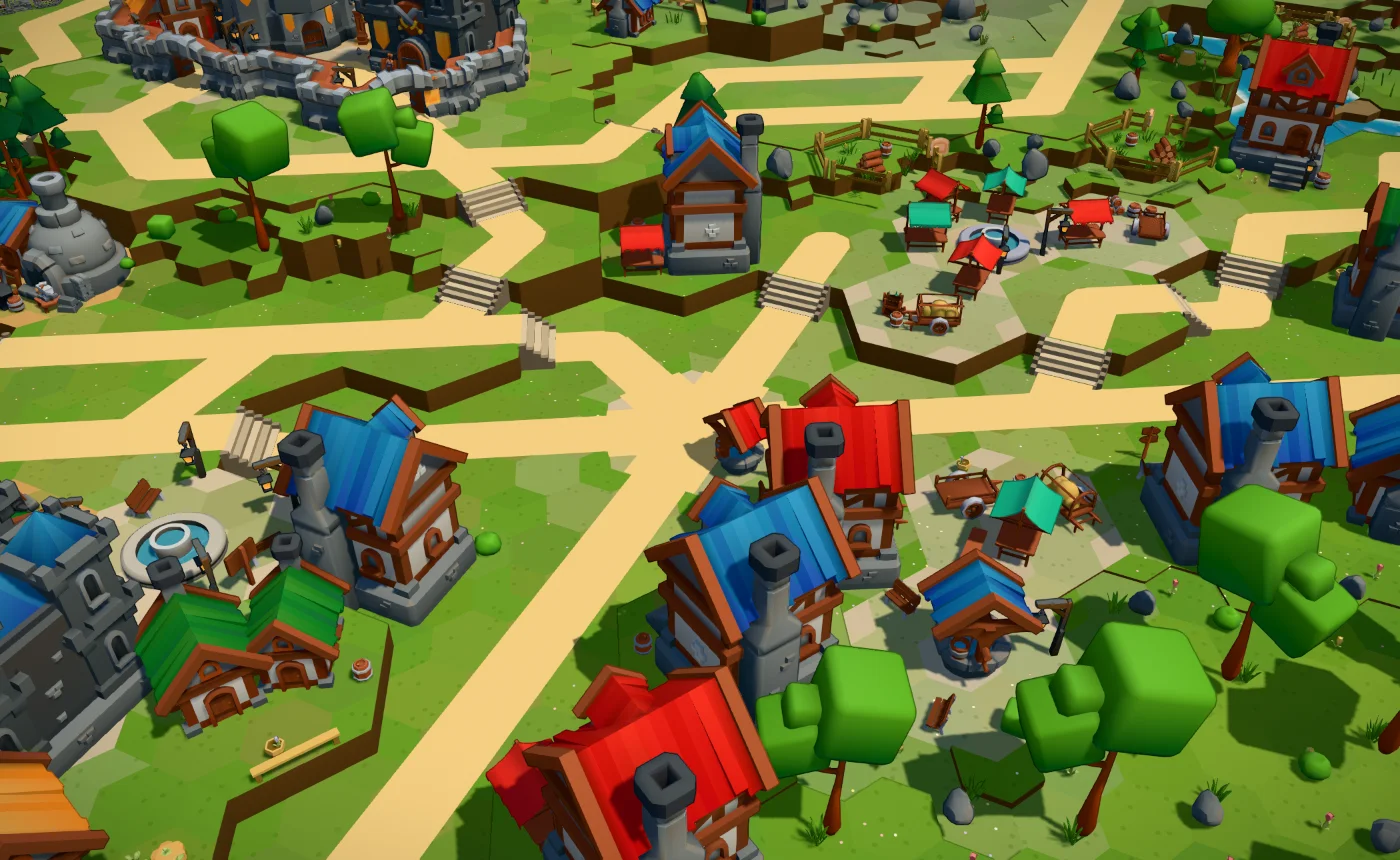
Todas las piezas estáticas entran en un `BatchedMesh` de three.js. Las geometrías comparten un juego de buffers; la isla se dibuja con un solo multi-draw. Un fotograma completo son unas 35 draw calls — por eso aún no valía la pena pasar a WebGPU: el cuello no eran las draw calls. En Metal lo caro es el número de instancias, no el de triángulos. Antes de cada pase, el batch de three recorre cada instancia: test de frustum, rango de geometría a la lista y subida. Con unas 18.000 instancias, ese recorrido es la factura. Lo sustituyó por su propio `LodBatchedMesh`: los niveles LOD viven en los mismos buffers; entre niveles se lista dos veces con código de dither y crossfade en una banda de unos 2 a 2,8 píxeles CSS; los clústeres lejanos pasan a una instancia-cáscara; con cámara quieta se reutiliza la lista. Apagar el LOD (`?lod=0`) hace la vista ancha 23–25 ms más lenta. Pero solo cambia donde la diferencia es de unos un píxel, y hace fade.
Las sombras siguen al sol sin recorrer la isla cada vez. Tres cascadas: cercana de unos 30 m a unos 2,3 cm por texel, media a 100 m, y una para todo el pueblo. Con cámara quieta no se re-renderizan; cada cuarto de grado de giro del sol (`SHADOW_TURN = 0.25°`) redibuja las tres. Con el día en marcha son unas 30 re-renderizaciones de cascada por segundo. El libro puso un número inesperado: el día en marcha costaba al héroe unos 30 fps (85 → 56 en perfil portátil, 105 → 58 en teléfono). Un giro más grueso redibujaría menos, pero las sombras saltarían a la vista — la regla dice no. La ronda 4 dio a los pases laterales sus propios buffers para que una re-renderización de cascada no forzara otro recorrido de ~18k y subida con cámara quieta. La ronda 5 conserva la lista de la cascada del pueblo (la caja cubre toda la isla desde cualquier ángulo solar; se construye una vez hasta que cambie una instancia) y añade una rejilla de culling de unos 32 × 32; el recorrido sigue en orden de instancias, la lista es la misma en el mismo orden, y un test lo prueba. CPU p95 del día en marcha (CPU ×4 throttle): portátil 22,4 → 19,8 ms (ronda 4), héroe 19,3 → 16,2 (ronda 5), héroe teléfono 18,5 → 16,2; cada fila de día en marcha en la ronda 5 bajó 2,3 a 3,4 ms. También es honesto sobre lo que no hizo: el fotograma que gira el sol sigue dibujando tres cascadas en la GPU, así que la vista ancha en el perfil portátil no se movió.
Los tirones tampoco estaban donde esperaba. Cada fotograma por encima de 25 ms convergía en lo mismo: programas de shader enlazando en el primer uso. En ANGLE sobre Metal un programa típico espera 30–50 ms; los pesados, cientos. La extensión de compilación paralela puede reportar listo antes de que Metal termine. Un periodo de gracia medido de 2 s aún dejó un hitch de 35 ms. Así que cada programa que el mundo necesitará se enlaza bajo la cubierta de carga; los de espectáculo se clavan; el warm-up del batch usa ahora sustitutos de un triángulo con atributos reales. En la isla de 12k, fotogramas >25 ms de 10 a 1; programas compilados antes del reveal de 40 a 32.
El mundo se construye en un worker. En la ronda 2 el plan de vida también pasó a un worker — el mismo plan byte a byte, probado por test. Tarea más larga del hilo principal tras el primer fotograma: 4.000 archivos 1.999 → 323 ms; 12.000 3.767 → 495 ms. Quedaba un stall de ~2,4 s que no era CPU ni compile de shader: el batch se dibujaba mientras la geometría aún se copiaba a rodajas; cada `bufferSubData` a un buffer que el fotograma anterior aún dibujaba hacía que ANGLE/Metal copiara de nuevo ~130 MB enteros. La solución fue casi aburrida: ocultar el batch hasta que toda la geometría esté dentro y subir una sola vez. Construcción del batch 4,8–5,1 → 1,1–1,4 s; isla entera 10,5 → 4,5 s. Eso no estaba en la lista de nadie. Vino de leer el trace y preguntar por qué una llamada GL esperaría en una GPU ociosa.
En el cable, Vercel comprime texto y JS pero envía el `.glb` tal cual. Solo el rig del personaje pesaba 3,14 MB. El build envía cada GLB de biblioteca gzippeado; la página infla con `DecompressionStream`, decidiendo por bytes `1f 8b`, no por nombre de archivo. Primera carga de un pueblo: 9,25 → 5,24 MB transferidos; GLB 7,89 → 4,02; rig 3,14 → 0,86; peticiones 412 → 311.
El último pase de la ronda 2 fueron commits pequeños y separados, cada uno medido: lámparas apagadas de día gratis, un material de paleta compartido por tipo de objeto, sin doble antialiasing con SMAA, menos basura por fotograma. Sin tope, 4k héroe p50/p95 8,9 / 11,7 → 6,3 / 8,1; 12k héroe 9,0 / 12,4 → 6,3 / 8,3. Los fotogramas bajaron aproximadamente un 25–35%. Las mismas imágenes.
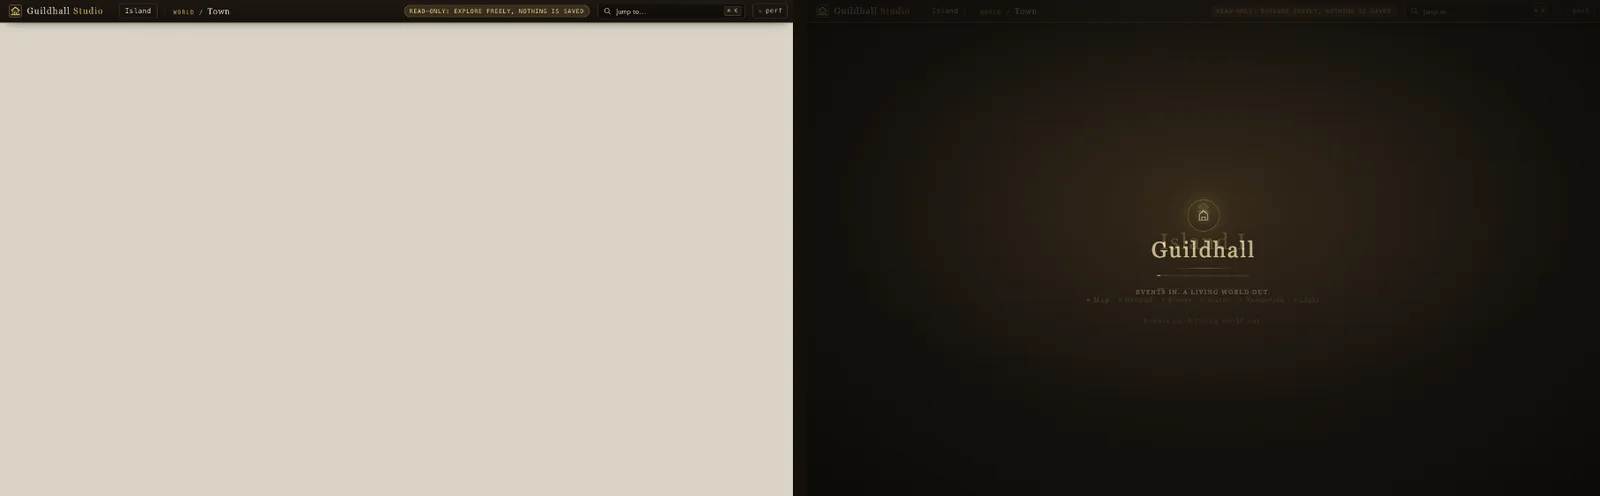
La ronda 3 fueron los primeros segundos. Antes, al abrir un pueblo parpadeaba un lienzo pálido vacío bajo el chrome del Studio; ahora una cubierta de boot en línea pinta desde el primer fotograma y hace fade a la cubierta del mundo — sin fotograma en blanco tras el primer paint en las capturas. El worker de vida empieza a planificar hacia 1 s para que el plan aterrice mientras el batch aún se construye. Cargas en frío, vsync on, mediana de tres: reveal 4k 4,9 → 3,7 s; 12k 7,1 → 5,1 s. Seiscientos milisegundos de cada reveal son el fade propio de la cubierta; lo dejó, porque el fade es parte del momento.
4. Ritmo antes de la escalera de calidad, y una tabla honesta de noes
La última lección sobre «fluido» es que el ritmo va antes de cualquier bajada de calidad. Una tasa que salta entre 60, 40 y 30 se siente peor que un 30 estable. El escenario dibuja en cada n-ésimo vsync; los vsync saltados no dibujan ni ejecutan hooks; toda animación corre en tiempo real transcurrido, así que nada se ralentiza a 30. Auto baja tras dos segundos malos seguidos y solo sube tras ocho calmados; si la subida no se sostiene, la siguiente espera se duplica. Settings → Motion ofrece Auto, Smooth 30 o Max. En un teléfono emulado (390 × 844, DPR 3, CPU ×6), los fotogramas pasaron de 33,4 / 41,0 ms a 16,7 / 18,4 ms: un 60 estable en un panel de 120 Hz. Solo cuando ni el cadencia de 30 se sostiene baja la escalera de calidad, un peldaño cada vez — `TIERS` del look completo (dprFloor 1,5, shadowMap 2048, lodBias 1, partículas 256) al más bajo (0,75 / 1024 / 2,5 / 64). Los teléfonos empiezan un peldaño abajo, las GPU débiles dos; Auto vuelve tras 20 segundos calmados. En su M1 los peldaños casi no mueven el fotograma — la isla allí es GPU-bound sea cual sea la resolución de sombra —, por eso la escalera se sienta detrás del ritmo.
Cada ronda terminó igual. Un look sheet: misma isla, mismo reloj congelado, 5 zooms a mediodía, 16:30 y 19:30, capturados antes y después, diff píxel a píxel. En la ronda 3, las 15 tomas coincidieron con diferencia media 0,000/255: byte a byte. En las rondas 4 y 5 la única diferencia fue una pieza plana en el zoom más cercano que aparece y desaparece entre dos capturas del mismo build. Una franja de sol en movimiento de 48 fotogramas también fue idéntica byte a byte. Esa es la barra: si la imagen se movió, la optimización no entra.
La parte de los libros que más le gusta son los negativos honestos. Muchas «victorias seguras» de la lista de la ronda 4 midieron lo contrario: cull de proyectores menores que un texel — casi nada es sub-texel donde cuestan las sombras; a dos texeles desaparecería un punto de sombra visible — no se construyó; sacar a la multitud de cascadas lejanas — ya es así, nada que hacer; saltar el agua bajo la isla / agua lejana más barata — construido y medido dos veces, ancha y héroe sin cambio; un ahorro real de agua lejana desvanecería las olas antes — cambio de look — descartado; suavizado lejano más ligero, repartir re-renderizaciones de cascada, redibujar sombras menos a menudo al girar el sol — mismo coste o visible — no construido o rechazado. Una cosa aceptó: una isla de 12.000 archivos desde la vista más ancha sigue pesando en el perfil portátil. Las palancas que quedan tocan el look. Su nota: «12k is too big and crazy.» Las islas de tamaño demo van fluidas; prefiere decirlo a embarcar un reino más borroso.
El tema de la serie se cierra aquí con claridad: la experiencia define el problema, las reglas y la aceptación; la IA ejecuta rápido. Casi toda la escritura la hizo el modelo. Él escribió el contrato y el plan, delegó las pasadas largas y decidió qué salía. La ejecución fue rápida porque las reglas eran claras. Lo que vino de la experiencia: la regla de rendimiento invisible antes del primer commit; aislar la máquina antes de confiar en un número; leer un trace y preguntar por qué una copia de buffer esperaría en una GPU ociosa; dejar que el look sheet anulara sus propias ideas cuando decía no.
Cierre: independencia es pagar por la aceptación «invisible»
Devuelve esta nota del 18 de octubre al suelo de juegos de navegador del otoño de 2026 y lo que golpea primero es un hábito de producción más quieto: la gente asume que optimizar es cambiar la imagen, asume que los eslóganes de FPS pesan más que la evidencia de píxeles, asume que «ya corre» basta, y rara vez pregunta si el reino después del arreglo sigue siendo el mismo. Estrada abre otro camino. El contrato puede ser tan llano como seis poses fijas y tres repeticiones. La aceptación puede ser tan dura como media 0,000/255. Una tabla de negativos puede clavar en público las «victorias seguras». La IA puede ser rápida; un humano debe decidir qué zarpa.
Para equipos pequeños el material es especialmente útil. Puede que no tengas BatchedMesh de 18k instancias ni Fable 5.1. Sí tienes tu lista de «ya basta»: una optimización que solo mira fotogramas medios, no una máquina quieta; un LOD que salta al hacer zoom escrito como «el jugador no se entera»; sombras que dan pasos por FPS; un warm-up que compiló una variante que nunca se dibujó; un «ahorro de agua» que midió igual antes/después y aun así quería quedarse en main como victoria. El trabajo público de Guildhall escribe el coste en tierra llana. Un look sheet puede ponerse negro a cero. Un libro puede ser una técnica por línea. Lo caro es pagar el checkpoint humano antes del merge — y admitir en el archivo de decisiones que 12k desde la vista más ancha sigue siendo demasiado loco.
Consejos accionables cortos:
- Antes del primer commit de rendimiento, escribe una regla de veto: qué aspectos, una vez deformados, hacen que la optimización no gane; pon «invisible» en el archivo de decisiones, no en excusas posteriores.
- Poses fijas, repeticiones, máquina quieta, dispositivo real — aterriza al menos un juego completo; revierte ganancias menores que el ruido; no declares victoria por sensación.
- Una técnica por commit, cada una con before → after; para culls y suavizados que puedan mover la imagen, corre look sheets o diffs de bytes primero — negro, luego merge.
- Ritmo antes que la escalera de calidad: mejor un 30 estable que aletear entre 60 y 30; mueve la escalera solo cuando el propio 30 no se sostiene, y registra qué «victorias seguras» vetó.
Doce mil archivos, unas treinta mil piezas, treinta y cinco draw calls, un diff de 0,000, y una línea — «12k is too big and crazy». Mientras el demo sigue corriendo y el código y los libros siguen públicos, el autor ya fijó el estándar de auditoría: no «¿puede llegar a sesenta?», sino «después de llegar a sesenta, ¿lo que ves sigue siendo el mismo reino?».

Fuentes y lectura adicional
Esteban Estrada (2026-10-18) Invisible Wins: 60 FPS for a Whole Kingdom, Even on a Phone
Esteban Estrada (2026-10-18) Feet That Don't Skate: Why 'It Looks Right' Is the Hardest Requirement